Superviser Graylog en production : Nagios pour le système, Prometheus pour l'application
Supervision complète d'une plateforme Graylog : CPU, RAM, disques, processus et services avec Nagios, puis journal, buffers, leader, archivage et OpenSearch avec Prometheus. Métriques, seuils et configuration pas à pas.
Graylog est souvent le dernier rempart de la détection : s'il s'arrête, se sature ou perd des messages, le SOC devient aveugle sans forcément s'en rendre compte. Une plateforme de journaux doit donc être elle-même supervisée, avec deux niveaux complémentaires :
- la supervision système avec Nagios : CPU, RAM, disques, processus, services, ports ;
- la supervision applicative avec Prometheus : journal, buffers, débit, nœud leader, état du répartiteur, archivage, santé d'OpenSearch et de MongoDB.
Cet article détaille les métriques à suivre, les seuils recommandés et la configuration complète, en prenant l'exemple d'un cluster de 3 nœuds Graylog (gl01 à gl03), 3 nœuds OpenSearch (os01 à os03) et MongoDB en replica set.
Vue d'ensemble
| Couche | Outil | Ce qui est surveillé |
|---|---|---|
| Système | Nagios + NRPE sur chaque serveur | Charge CPU, mémoire, disques et inodes, processus, services systemd, ports, synchronisation horaire |
| Application Graylog | Prometheus + exporteur intégré à Graylog (port 9833) | Journal, buffers, débit entrant et sortant, mémoire Java |
| API Graylog | blackbox_exporter et json_exporter | État du nœud pour le répartiteur (lbstatus), présence d'un leader, certificats |
| OpenSearch et MongoDB | elasticsearch_exporter, mongodb_exporter | Santé du cluster, shards, espace disque, mémoire, disponibilité de MongoDB |
| Archivage | Scripts + collecteur textfile de node_exporter | Dernière archive Graylog réussie, dernier snapshot OpenSearch, erreurs d'indexation |
| Alertes | Alertmanager, Grafana | Notification par e-mail ou messagerie, tableaux de bord |
Architecture des flux de supervision
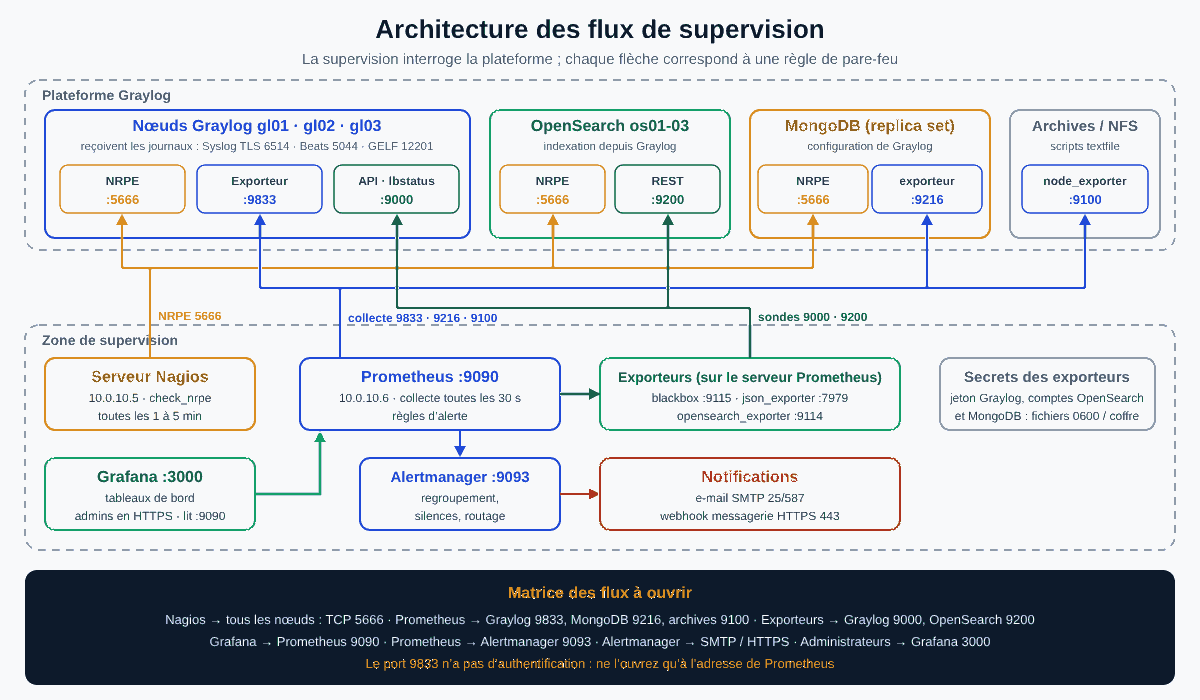
Toute la supervision fonctionne en mode pull : c'est la zone de supervision qui interroge la plateforme, jamais l'inverse. Seules les notifications de l'Alertmanager sortent vers la messagerie. Cette organisation simplifie le pare-feu et limite la surface d'attaque : un attaquant qui compromettrait un nœud Graylog ne peut pas atteindre les serveurs de supervision.
Les exporteurs qui interrogent des API (blackbox, json_exporter, opensearch_exporter) sont installés sur le serveur Prometheus et n'écoutent qu'en local. Ceux qui lisent des données locales (node_exporter, mongodb_exporter) sont installés sur les serveurs concernés.
Matrice des flux à ouvrir
| Source | Destination | Port | Usage | Sécurisation |
|---|---|---|---|---|
| Serveur Nagios | Tous les nœuds (Graylog, OpenSearch, MongoDB) | TCP 5666 | Contrôles NRPE | allowed_hosts limité au serveur Nagios, TLS NRPE |
| Prometheus | Nœuds Graylog | TCP 9833 | Exporteur intégré à Graylog | Aucune authentification : pare-feu strict vers l'adresse de Prometheus |
| Prometheus | Nœuds MongoDB | TCP 9216 | mongodb_exporter | Pare-feu, compte MongoDB en lecture |
| Prometheus | Serveur d'archives | TCP 9100 | node_exporter et métriques textfile | Pare-feu |
| blackbox et json_exporter | Nœuds Graylog | TCP 9000 (HTTPS) | lbstatus, API du cluster, certificats | Jeton d'API d'un compte de service |
| opensearch_exporter | Nœuds OpenSearch | TCP 9200 (HTTPS) | Santé, shards, disques, mémoire | Compte OpenSearch dédié, droits de lecture |
| Script d'archivage | OpenSearch et Graylog | TCP 9200 et 9000 | Snapshots, erreurs d'indexation | Comptes dédiés, secrets en fichier protégé |
| Grafana | Prometheus | TCP 9090 | Requêtes des tableaux de bord | Réseau d'administration |
| Prometheus | Alertmanager | TCP 9093 | Envoi des alertes | Local ou réseau d'administration |
| Alertmanager | Passerelle SMTP, messagerie | TCP 25/587, 443 | Notifications | TLS |
| Administrateurs | Grafana | TCP 3000 (HTTPS) | Consultation | Authentification unique et MFA |
Partie 1 : la supervision système avec Nagios
Installer l'agent NRPE
Sur chaque nœud Graylog, OpenSearch et MongoDB (exemple sous RHEL et dérivés, avec le dépôt EPEL) :
dnf install -y epel-release
dnf install -y nrpe nagios-plugins-load nagios-plugins-disk nagios-plugins-procs \
  nagios-plugins-swap nagios-plugins-tcp nagios-plugins-http nagios-plugins-ntp

# Autoriser uniquement le serveur Nagios
sed -i 's/^allowed_hosts=.*/allowed_hosts=127.0.0.1,10.0.10.5/' /etc/nagios/nrpe.cfg
systemctl enable --now nrpe
firewall-cmd --permanent --add-port=5666/tcp --zone=internal && firewall-cmd --reload
Deux petits plugins utiles
Les plugins standard ne mesurent pas directement la mémoire disponible ni l'état d'une unité systemd. Deux scripts courts suffisent :
# /usr/lib64/nagios/plugins/check_mem.sh : mémoire disponible en %
#!/bin/bash
WARN=${1:-15}; CRIT=${2:-8}
total=$(awk '/MemTotal/ {print $2}' /proc/meminfo)
avail=$(awk '/MemAvailable/ {print $2}' /proc/meminfo)
pct=$(( avail * 100 / total ))
msg="Memoire disponible ${pct}% | mem_avail_pct=${pct}%;${WARN};${CRIT};0;100"
if [ "$pct" -le "$CRIT" ]; then echo "CRITICAL - $msg"; exit 2
elif [ "$pct" -le "$WARN" ]; then echo "WARNING - $msg"; exit 1
else echo "OK - $msg"; exit 0; fi
# /usr/lib64/nagios/plugins/check_unit.sh : etat d'un service systemd
#!/bin/bash
state=$(systemctl is-active "$1" 2>/dev/null)
if [ "$state" = "active" ]; then echo "OK - $1 actif"; exit 0
else echo "CRITICAL - $1 est $state"; exit 2; fiRendez-les exécutables (chmod 755). Point d'attention : sur un serveur Graylog ou OpenSearch, la mémoire « utilisée » est naturellement élevée (heap Java, cache du système de fichiers). Mesurez la mémoire disponible (MemAvailable), pas la mémoire libre.
Les commandes NRPE
# /etc/nrpe.d/graylog.cfg (noeuds Graylog)
command[check_load]=/usr/lib64/nagios/plugins/check_load -r -w 0.85,0.75,0.70 -c 1.0,0.95,0.90
command[check_mem]=/usr/lib64/nagios/plugins/check_mem.sh 15 8
command[check_swap]=/usr/lib64/nagios/plugins/check_swap -w 50% -c 25%
command[check_disk_root]=/usr/lib64/nagios/plugins/check_disk -w 20% -c 10% -W 20% -K 10% -p /
command[check_disk_var]=/usr/lib64/nagios/plugins/check_disk -w 20% -c 10% -p /var
command[check_disk_journal]=/usr/lib64/nagios/plugins/check_disk -w 30% -c 15% -p /var/lib/graylog-server
command[check_proc_graylog]=/usr/lib64/nagios/plugins/check_procs -c 1:1 -C java -a graylog
command[check_unit_graylog]=/usr/lib64/nagios/plugins/check_unit.sh graylog-server
command[check_zombies]=/usr/lib64/nagios/plugins/check_procs -s Z -w 5 -c 10
command[check_total_procs]=/usr/lib64/nagios/plugins/check_procs -w 400 -c 600
command[check_port_api]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 9000
command[check_port_beats]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 5044
command[check_port_syslog]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 6514
command[check_port_gelf]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 12201
command[check_lbstatus]=/usr/lib64/nagios/plugins/check_http -H 127.0.0.1 -p 9000 -u /api/system/lbstatus -s ALIVE
command[check_ntp]=/usr/lib64/nagios/plugins/check_ntp_time -H ntp.exemple.local -w 0.5 -c 1

# /etc/nrpe.d/opensearch.cfg (noeuds OpenSearch)
command[check_disk_data]=/usr/lib64/nagios/plugins/check_disk -w 25% -c 18% -p /var/lib/opensearch
command[check_unit_opensearch]=/usr/lib64/nagios/plugins/check_unit.sh opensearch
command[check_port_opensearch]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 9200

# /etc/nrpe.d/mongodb.cfg (noeuds MongoDB)
command[check_unit_mongod]=/usr/lib64/nagios/plugins/check_unit.sh mongod
command[check_proc_mongod]=/usr/lib64/nagios/plugins/check_procs -c 1:1 -C mongod
command[check_port_mongod]=/usr/lib64/nagios/plugins/check_tcp -H 127.0.0.1 -p 27017
Adaptez les ports à vos inputs réels. L'option -r de check_load divise la charge par le nombre de cœurs : les seuils s'expriment donc par cœur, quel que soit le serveur.
Côté serveur Nagios
define command {
  command_name  check_nrpe
  command_line  $USER1$/check_nrpe -H $HOSTADDRESS$ -t 30 -c $ARG1$
}

define hostgroup {
  hostgroup_name  graylog-nodes
  members         gl01,gl02,gl03
}

define service {
  use                  generic-service
  hostgroup_name       graylog-nodes
  service_description  Disque journal Graylog
  check_command        check_nrpe!check_disk_journal
  check_interval       5
  retry_interval       1
  max_check_attempts   3
}

define service {
  use                  generic-service
  hostgroup_name       graylog-nodes
  service_description  Service graylog-server
  check_command        check_nrpe!check_unit_graylog
  check_interval       1
  max_check_attempts   2
}
Dupliquez le bloc define service pour chaque commande NRPE, avec un intervalle court (1 minute) pour les services et les ports, et plus long (5 minutes) pour les disques et la charge.
Les seuils système recommandés
| Contrôle | Avertissement | Critique | Pourquoi |
|---|---|---|---|
| Charge CPU par cœur (1, 5, 15 min) | 0,85 / 0,75 / 0,70 | 1,0 / 0,95 / 0,90 | Une charge durable au-dessus de 1 par cœur ralentit le traitement des messages |
| Mémoire disponible | 15 % | 8 % | Risque d'arrêt brutal par le noyau (OOM killer) |
| Swap libre | 50 % | 25 % | Une JVM qui swappe devient très lente |
| Disque système et /var libres | 20 % | 10 % | Journaux système, mises à jour |
| Disque du journal Graylog libre | 30 % | 15 % | Le journal grossit dès que l'indexation ralentit |
| Disque de données OpenSearch libre | 25 % | 18 % | Anticiper les seuils d'OpenSearch : allocation bloquée à 85 %, puis 90 %, index en lecture seule à 95 % |
| Inodes libres | 20 % | 10 % | Nombreux petits fichiers (segments, archives) |
| Processus graylog-server, opensearch, mongod | - | différent de 1 | Service arrêté ou lancé en double |
| Processus zombies | 5 | 10 | Signe d'un problème applicatif |
| Décalage horaire | 0,5 s | 1 s | Horodatage et corrélation des événements |
Partie 2 : la supervision applicative avec Prometheus
Comprendre le pipeline interne de Graylog
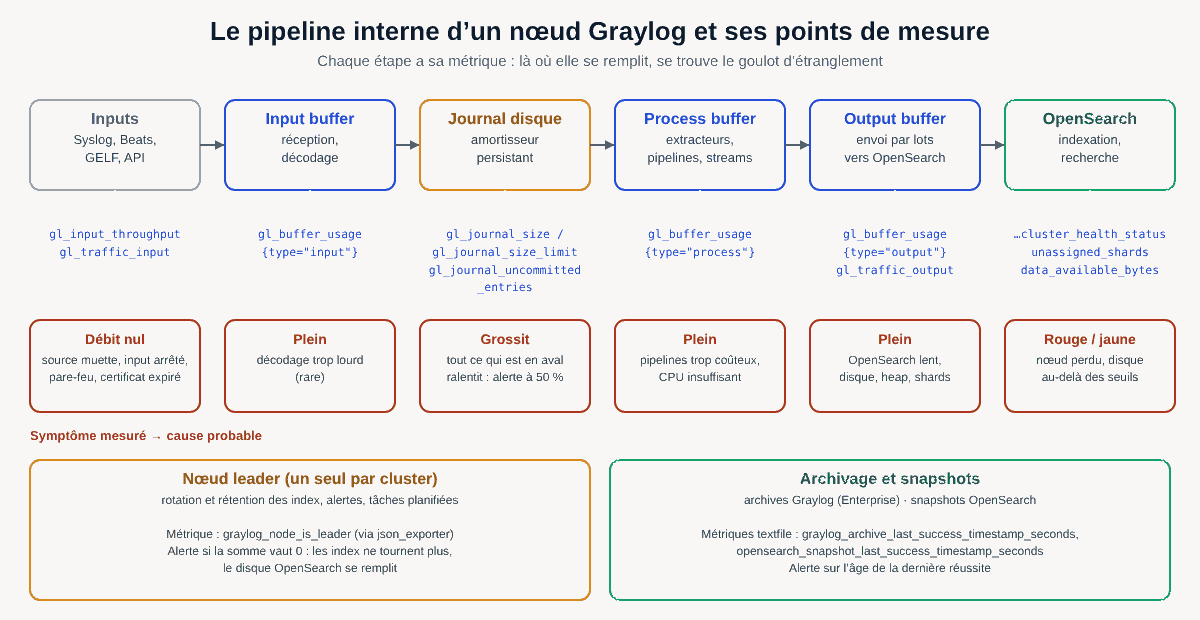
Avant de configurer les alertes, il faut comprendre le chemin d'un message dans un nœud Graylog, car chaque métrique correspond à une étape :
- Inputs : réception (Syslog, Beats, GELF). Métriques
gl_input_throughputetgl_traffic_input. Un débit nul signale une source muette, un input arrêté, un pare-feu ou un certificat expiré. - Input buffer : décodage des messages. Il sature rarement.
- Journal disque : chaque message est écrit sur disque avant traitement. C'est l'amortisseur qui évite les pertes quand l'aval ralentit. Sa taille est limitée par
message_journal_max_size(5 Go par défaut) etmessage_journal_max_age(12 heures par défaut) : au-delà, les messages les plus anciens sont supprimés, donc perdus. - Process buffer : extracteurs, règles de pipeline, routage vers les streams. Le nombre de threads est réglé par
processbuffer_processors. - Output buffer : envoi par lots vers OpenSearch, avec
outputbuffer_processorsthreads. - OpenSearch : indexation. Sa santé conditionne tout le reste.
La règle de diagnostic est simple : le journal ne grossit jamais sans raison. Regardez quel buffer est plein juste après lui. Process buffer plein : ajoutez des cœurs ou allégez les pipelines (expressions régulières, recherches dans des tables). Output buffer plein : le problème est côté OpenSearch (disque, heap Java, trop de shards, nœud perdu).
Dimensionnez le journal pour absorber plusieurs heures d'indisponibilité d'OpenSearch. Exemple : 1 To de journaux par jour répartis sur 3 nœuds, soit environ 14 Go par heure et par nœud ; pour tenir 4 heures, il faut environ 56 Go. On règle alors message_journal_max_size = 80gb, sur un disque dédié et rapide, et l'on adapte l'alerte de remplissage.
Préparer le serveur de supervision
Exemple sous Linux pour Prometheus ; la même méthode s'applique à Alertmanager et aux exporteurs, tous distribués sous forme de binaires sur GitHub.
# Compte de service et repertoires
useradd --system --no-create-home --shell /sbin/nologin prometheus
mkdir -p /etc/prometheus/rules /etc/prometheus/targets /var/lib/prometheus

# Installation (prendre la derniere version stable sur prometheus.io/download)
VERSION=3.x.y
curl -LO https://github.com/prometheus/prometheus/releases/download/v${VERSION}/prometheus-${VERSION}.linux-amd64.tar.gz
tar xzf prometheus-${VERSION}.linux-amd64.tar.gz
install -m 755 prometheus-${VERSION}.linux-amd64/prometheus /usr/local/bin/
install -m 755 prometheus-${VERSION}.linux-amd64/promtool /usr/local/bin/
chown -R prometheus:prometheus /etc/prometheus /var/lib/prometheus
# /etc/systemd/system/prometheus.service
[Unit]
Description=Prometheus
After=network-online.target
Wants=network-online.target
[Service]
User=prometheus
Group=prometheus
ExecStart=/usr/local/bin/prometheus \
--config.file=/etc/prometheus/prometheus.yml \
--storage.tsdb.path=/var/lib/prometheus \
--storage.tsdb.retention.time=90d \
--web.listen-address=10.0.10.6:9090 \
--web.enable-lifecycle
ExecReload=/bin/kill -HUP $MAINPID
Restart=on-failure
NoNewPrivileges=true
ProtectSystem=full
ProtectHome=true
[Install]
WantedBy=multi-user.targetLes exporteurs suivent le même modèle d'unité systemd. Lignes ExecStart type, en n'écoutant qu'en local pour ceux qui tournent sur le serveur Prometheus :
# blackbox_exporter (sur le serveur Prometheus)
ExecStart=/usr/local/bin/blackbox_exporter --config.file=/etc/prometheus/blackbox.yml --web.listen-address=127.0.0.1:9115

# json_exporter (sur le serveur Prometheus)
ExecStart=/usr/local/bin/json_exporter --config.file=/etc/json_exporter/config.yml --web.listen-address=127.0.0.1:7979

# elasticsearch_exporter pour OpenSearch (sur le serveur Prometheus)
EnvironmentFile=/etc/prometheus/opensearch.env    # ES_USERNAME=... ES_PASSWORD=... (chmod 600)
ExecStart=/usr/local/bin/elasticsearch_exporter --es.uri=https://os01.exemple.local:9200 --es.ca=/etc/prometheus/ca-entreprise.pem --es.all --es.indices --web.listen-address=127.0.0.1:9114

# node_exporter (sur le serveur d'archives)
ExecStart=/usr/local/bin/node_exporter --collector.textfile.directory=/var/lib/node_exporter/textfile

# mongodb_exporter (sur chaque noeud MongoDB)
EnvironmentFile=/etc/mongodb_exporter.env          # MONGODB_URI=mongodb://monitor:...@127.0.0.1:27017/admin (chmod 600)
ExecStart=/usr/local/bin/mongodb_exporter --collect-all --web.listen-address=:9216
Si les exporteurs tournent sur le serveur Prometheus, remplacez dans prometheus.yml (étape 7) les adresses blackbox.exemple.local:9115, jsonexporter.exemple.local:7979 et esexporter.exemple.local:9114 par 127.0.0.1.
Créer les comptes de supervision
Chaque exporteur utilise un compte dédié, avec le minimum de droits, jamais un compte d'administrateur.
Graylog : dans System, Users and Teams, créez un utilisateur svc-prometheus avec le rôle Reader, puis, dans le menu de cet utilisateur, Edit tokens, créez un jeton nommé prometheus. Testez-le :
curl -s --cacert /etc/prometheus/ca-entreprise.pem -u "$GL_TOKEN:token" \
  https://gl01.exemple.local:9000/api/system/cluster/nodes | jq '.nodes[] | {hostname, is_leader}'
Si l'appel est refusé (code 403), le rôle est insuffisant pour votre version : attribuez à ce compte de service le rôle minimal qui permet de lire les nœuds et les erreurs d'indexation, et réservez-le à l'API.
OpenSearch : un rôle de lecture et un utilisateur, via l'API du plugin de sécurité (l'administrateur saisit son mot de passe à l'invite) :
OS=https://os01.exemple.local:9200
CA=--cacert=/etc/prometheus/ca-entreprise.pem

curl -s $CA -u admin -X PUT "$OS/_plugins/_security/api/roles/prometheus_monitor" \
  -H 'Content-Type: application/json' -d '{
  "cluster_permissions": ["cluster_monitor", "cluster:admin/snapshot/get", "cluster:admin/repository/get"],
  "index_permissions": [{"index_patterns": ["*"], "allowed_actions": ["indices_monitor"]}]
}'

curl -s $CA -u admin -X PUT "$OS/_plugins/_security/api/internalusers/prometheus" \
  -H 'Content-Type: application/json' -d '{"password": "MOT_DE_PASSE_LONG_ET_ALEATOIRE"}'

curl -s $CA -u admin -X PUT "$OS/_plugins/_security/api/rolesmapping/prometheus_monitor" \
  -H 'Content-Type: application/json' -d '{"users": ["prometheus"]}'
MongoDB : un utilisateur avec le rôle clusterMonitor, depuis mongosh :
use admin
db.createUser({
  user: "monitor",
  pwd: passwordPrompt(),
  roles: [ { role: "clusterMonitor", db: "admin" }, { role: "read", db: "local" } ]
})
Stockez tous ces secrets dans des fichiers lisibles uniquement par le compte de service concerné (chmod 600), ou dans votre coffre-fort de secrets, et prévoyez leur renouvellement.
Étape 1 : activer l'exporteur intégré à Graylog
Depuis la version 4.1, Graylog expose ses métriques au format Prometheus. Sur chaque nœud, dans /etc/graylog/server/server.conf :
prometheus_exporter_enabled = true
# Par defaut 127.0.0.1:9833 : ecouter sur l'adresse du noeud pour Prometheus
prometheus_exporter_bind_address = 10.0.20.11:9833
# Optionnel : correspondances supplementaires (voir plus bas)
prometheus_exporter_mapping_file_path_custom = /etc/graylog/server/prometheus-exporter-mapping-custom.yml
systemctl restart graylog-server
firewall-cmd --permanent --zone=internal --add-rich-rule='rule family=ipv4 source address=10.0.10.6/32 port port=9833 protocol=tcp accept'
firewall-cmd --reload
# Verifier depuis le serveur Prometheus
curl -s http://10.0.20.11:9833/api/metrics/prometheus | grep '^gl_' | sort | head -50L'endpoint ne demande pas d'authentification : limitez son accès au seul serveur Prometheus par le pare-feu. La dernière commande liste les métriques réellement disponibles : les noms peuvent varier légèrement selon la version de Graylog, vérifiez-les avant d'écrire vos alertes.
Les métriques Graylog essentielles
| Métrique | Signification | Valeur saine |
|---|---|---|
up{job="graylog"} | Le nœud répond à Prometheus (générée par Prometheus) | 1 sur tous les nœuds |
gl_journal_size et gl_journal_size_limit | Taille du journal disque et taille maximale configurée | Ratio inférieur à 10 % en régime normal |
gl_journal_append_1_sec_rate | Messages écrits dans le journal par seconde | Proche du débit entrant attendu |
gl_buffer_usage{type="input|process|output"} et gl_buffer_size | Remplissage des trois buffers internes | Proche de 0 ; un buffer plein en permanence signale un goulot |
gl_traffic_input / gl_traffic_output | Volume reçu et envoyé (compteurs, en octets) | Stable d'un jour sur l'autre |
gl_input_throughput | Débit des inputs | Jamais nul en journée |
gl_jvm_memory_heap_used / gl_jvm_memory_heap_max | Mémoire Java utilisée et maximale | Inférieur à 80 % en moyenne |
Comment lire les buffers : un buffer process plein indique que les règles de pipeline et les extracteurs sont trop lourds pour le CPU disponible ; un buffer output plein indique qu'OpenSearch n'indexe pas assez vite. Dans les deux cas, les messages s'accumulent dans le journal, qui sert d'amortisseur.
Étape 2 : ajouter des métriques avec un fichier de correspondance
Le fichier de correspondance personnalisé exporte des métriques internes de Graylog qui ne le sont pas par défaut. Graylog le relit automatiquement toutes les 30 secondes. Exemple pour le nombre de messages non encore traités dans le journal et le débit par stream :
# /etc/graylog/server/prometheus-exporter-mapping-custom.yml
metric_mappings:
  - metric_name: "journal_uncommitted_entries"
    match_pattern: "org.graylog2.journal.entries-uncommitted"
  - metric_name: "stream_incoming_messages"
    match_pattern: "org.graylog2.plugin.streams.Stream.*.incomingMessages"
    wildcard_extract_labels:
      - "stream"
Ces correspondances créent gl_journal_uncommitted_entries et gl_stream_incoming_messages{stream="<id>"}. Les noms internes disponibles sont visibles dans l'interface, menu System, Nodes, Metrics.
Étape 3 : surveiller l'API (lbstatus, certificats)
L'endpoint /api/system/lbstatus renvoie ALIVE quand le nœud peut recevoir du trafic, et DEAD ou THROTTLED sinon. C'est lui que doivent utiliser vos répartiteurs de charge. On le sonde avec blackbox_exporter :
# /etc/prometheus/blackbox.yml
modules:
  graylog_lbstatus:
    prober: http
    timeout: 5s
    http:
      valid_status_codes: [200]
      fail_if_body_not_matches_regexp: ["ALIVE"]
      tls_config:
        ca_file: /etc/prometheus/ca-entreprise.pem
Étape 4 : détecter la perte du leader (ex-« master »)
Dans un cluster Graylog, un seul nœud est leader (appelé « master » avant la version 4.1). Il exécute les tâches périodiques : rotation et rétention des index, alertes, certaines tâches de maintenance. Sans leader, les index ne tournent plus et le disque OpenSearch finit par se remplir. L'API /api/system/cluster/nodes indique pour chaque nœud s'il est leader ; json_exporter la transforme en métrique. Créez d'abord un utilisateur de service avec un rôle en lecture seule et un jeton d'accès.
# /etc/json_exporter/config.yml
modules:
  graylog_nodes:
    http_client_config:
      basic_auth:
        username: "JETON_API_GRAYLOG"   # authentification Graylog par jeton
        password: "token"
      tls_config:
        ca_file: /etc/prometheus/ca-entreprise.pem
    metrics:
      - name: graylog_node
        type: object
        help: "Noeuds du cluster Graylog"
        path: '{ .nodes[*] }'
        labels:
          hostname: '{ .hostname }'
          node_id: '{ .node_id }'
        values:
          is_leader: '{ .is_leader }'   # "is_master" avant Graylog 4.1
On obtient graylog_node_is_leader qui vaut 1 pour le leader et 0 pour les autres. Stockez le jeton avec des droits restreints (fichier lisible uniquement par le compte du service) et renouvelez-le régulièrement.
Étape 5 : OpenSearch et MongoDB
# elasticsearch_exporter (compatible OpenSearch dans la plupart des versions : a valider)
elasticsearch_exporter --es.uri=https://os01.exemple.local:9200 \
  --es.ca=/etc/prometheus/ca-entreprise.pem --es.all --es.indices \
  --web.listen-address=:9114
# identifiants via les variables ES_USERNAME et ES_PASSWORD

# mongodb_exporter (Percona)
mongodb_exporter --mongodb.uri=mongodb://monitor:MOT_DE_PASSE@mongo01:27017/admin \
  --collect-all --web.listen-address=:9216
Métriques clés : elasticsearch_cluster_health_status{color="red"}, elasticsearch_cluster_health_number_of_nodes, elasticsearch_cluster_health_unassigned_shards, elasticsearch_filesystem_data_available_bytes et elasticsearch_filesystem_data_size_bytes, elasticsearch_jvm_memory_used_bytes, et mongodb_up pour MongoDB.
Étape 6 : archivage, snapshots et erreurs d'indexation
Il n'existe pas de métrique native fiable pour « la dernière archive s'est bien passée ». La méthode la plus robuste : un script exécuté toutes les 5 minutes qui écrit des métriques dans le répertoire du collecteur textfile de node_exporter.
#!/bin/bash
# /usr/local/bin/graylog-archive-metrics.sh (cron toutes les 5 minutes)
OUT=/var/lib/node_exporter/textfile/graylog_archive.prom
TMP=$(mktemp)

# 1. Derniere archive Graylog (fonction Archive de Graylog Enterprise)
ARCHIVE_DIR=/srv/graylog-archives
last_archive=$(find "$ARCHIVE_DIR" -type f -printf '%T@\n' 2>/dev/null | sort -n | tail -1 | cut -d. -f1)
echo "graylog_archive_last_success_timestamp_seconds ${last_archive:-0}" >> "$TMP"

# 2. Dernier snapshot OpenSearch reussi
last_snap=$(curl -s --cacert /etc/prometheus/ca-entreprise.pem -u "$OS_USER:$OS_PASS" \
  "https://os01.exemple.local:9200/_cat/snapshots/depot-snapshots?format=json" \
  | jq '[.[] | select(.status=="SUCCESS") | .end_epoch | tonumber] | max // 0')
echo "opensearch_snapshot_last_success_timestamp_seconds ${last_snap:-0}" >> "$TMP"

# 3. Erreurs d'indexation Graylog sur les 5 dernieres minutes
since=$(date -u -d '-5 min' +%Y-%m-%dT%H:%M:%S.000Z)
failures=$(curl -s --cacert /etc/prometheus/ca-entreprise.pem -u "$GL_TOKEN:token" \
  "https://gl01.exemple.local:9000/api/system/indexer/failures/count?since=$since" | jq '.count // 0')
echo "graylog_indexer_failures_5m ${failures:-0}" >> "$TMP"

mv "$TMP" "$OUT" && chmod 644 "$OUT"
node_exporter doit être lancé avec --collector.textfile.directory=/var/lib/node_exporter/textfile. Les identifiants sont lus dans des variables d'environnement définies dans un fichier protégé, jamais écrits dans le script.
Étape 7 : la configuration de Prometheus
# /etc/prometheus/prometheus.yml
global:
  scrape_interval: 30s
  evaluation_interval: 30s

rule_files:
  - /etc/prometheus/rules/graylog.rules.yml

alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager.exemple.local:9093"]

scrape_configs:
  # 1. Exporteur integre a Graylog
  - job_name: graylog
    metrics_path: /api/metrics/prometheus
    static_configs:
      - targets: ["gl01.exemple.local:9833", "gl02.exemple.local:9833", "gl03.exemple.local:9833"]

  # 2. Etat lbstatus de chaque noeud, via blackbox_exporter
  - job_name: graylog_lbstatus
    metrics_path: /probe
    params:
      module: [graylog_lbstatus]
    static_configs:
      - targets:
          - https://gl01.exemple.local:9000/api/system/lbstatus
          - https://gl02.exemple.local:9000/api/system/lbstatus
          - https://gl03.exemple.local:9000/api/system/lbstatus
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - source_labels: [__param_target]
        target_label: instance
      - target_label: __address__
        replacement: blackbox.exemple.local:9115

  # 3. Leader du cluster, via json_exporter (un seul noeud suffit)
  - job_name: graylog_cluster
    metrics_path: /probe
    params:
      module: [graylog_nodes]
    static_configs:
      - targets: ["https://gl01.exemple.local:9000/api/system/cluster/nodes"]
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - source_labels: [__param_target]
        target_label: instance
      - target_label: __address__
        replacement: jsonexporter.exemple.local:7979

  # 4. OpenSearch, MongoDB et metriques textfile
  - job_name: opensearch
    static_configs:
      - targets: ["esexporter.exemple.local:9114"]
  - job_name: mongodb
    static_configs:
      - targets: ["mongo01.exemple.local:9216"]
  - job_name: node
    static_configs:
      - targets: ["gl01.exemple.local:9100", "archive01.exemple.local:9100"]
Pour la résilience, interrogez de préférence l'API du cluster par l'adresse du répartiteur plutôt que par un seul nœud, ou déclarez les trois nœuds et utilisez max dans les alertes.
Étape 8 : les règles d'alerte
# /etc/prometheus/rules/graylog.rules.yml
groups:
  - name: graylog-application
    rules:
      - alert: GraylogNoeudArrete
        expr: up{job="graylog"} == 0
        for: 2m
        labels: {severity: critical}
        annotations:
          summary: "Graylog ne repond plus sur {{ $labels.instance }}"
          description: "Service graylog-server arrete ou bloque. Verifier systemctl status graylog-server et server.log."

      - alert: GraylogAucunLeader
        expr: sum(graylog_node_is_leader) < 1
        for: 2m
        labels: {severity: critical}
        annotations:
          summary: "Aucun noeud leader dans le cluster Graylog"
          description: "Rotation et retention des index arretees : le disque OpenSearch va se remplir."

      - alert: GraylogPlusieursLeaders
        expr: sum(graylog_node_is_leader) > 1
        for: 5m
        labels: {severity: warning}
        annotations:
          summary: "Plusieurs noeuds se declarent leader"

      - alert: GraylogLbStatusDead
        expr: probe_success{job="graylog_lbstatus"} == 0
        for: 1m
        labels: {severity: critical}
        annotations:
          summary: "{{ $labels.instance }} n'est plus ALIVE pour le repartiteur"

      - alert: GraylogJournalSeRemplit
        expr: gl_journal_size / gl_journal_size_limit > 0.5
        for: 10m
        labels: {severity: warning}
        annotations:
          summary: "Journal Graylog rempli a plus de 50 % sur {{ $labels.instance }}"

      - alert: GraylogJournalCritique
        expr: gl_journal_size / gl_journal_size_limit > 0.8
        for: 5m
        labels: {severity: critical}
        annotations:
          summary: "Journal Graylog a plus de 80 % : risque de perte de messages"

      - alert: GraylogRetardTraitement
        expr: gl_journal_uncommitted_entries > 1000000 and deriv(gl_journal_uncommitted_entries[15m]) > 0
        for: 15m
        labels: {severity: warning}
        annotations:
          summary: "Plus d'un million de messages en attente et en hausse"

      - alert: GraylogBufferProcessSature
        expr: gl_buffer_usage{type="process"} / gl_buffer_size{type="process"} > 0.9
        for: 5m
        labels: {severity: warning}
        annotations:
          summary: "Buffer process sature : pipelines trop lourds ou CPU insuffisant"

      - alert: GraylogBufferOutputSature
        expr: gl_buffer_usage{type="output"} / gl_buffer_size{type="output"} > 0.9
        for: 5m
        labels: {severity: warning}
        annotations:
          summary: "Buffer output sature : OpenSearch n'indexe pas assez vite"

      - alert: GraylogAucunMessageRecu
        expr: sum(rate(gl_traffic_input{job="graylog"}[10m])) == 0
        for: 10m
        labels: {severity: critical}
        annotations:
          summary: "Plus aucun message recu par le cluster depuis 10 minutes"

      - alert: GraylogChuteDeTrafic
        expr: sum(rate(gl_traffic_input[30m])) < 0.5 * sum(rate(gl_traffic_input[30m] offset 1d))
        for: 30m
        labels: {severity: warning}
        annotations:
          summary: "Trafic entrant inferieur de moitie a celui d'hier a la meme heure"

      - alert: GraylogMemoireJava
        expr: gl_jvm_memory_heap_used / gl_jvm_memory_heap_max > 0.9
        for: 15m
        labels: {severity: warning}
        annotations:
          summary: "Heap Java au-dessus de 90 % sur {{ $labels.instance }}"

      - alert: GraylogErreursIndexation
        expr: graylog_indexer_failures_5m > 0
        for: 5m
        labels: {severity: warning}
        annotations:
          summary: "{{ $value }} erreurs d'indexation sur les 5 dernieres minutes"

      - alert: GraylogCertificatExpire
        expr: probe_ssl_earliest_cert_expiry{job="graylog_lbstatus"} - time() < 21 * 86400
        labels: {severity: warning}
        annotations:
          summary: "Certificat de {{ $labels.instance }} expirant dans moins de 21 jours"

  - name: graylog-archivage
    rules:
      - alert: ArchiveGraylogEnRetard
        expr: time() - graylog_archive_last_success_timestamp_seconds > 26 * 3600
        labels: {severity: critical}
        annotations:
          summary: "Aucune archive Graylog reussie depuis plus de 26 heures"

      - alert: SnapshotOpenSearchEnRetard
        expr: time() - opensearch_snapshot_last_success_timestamp_seconds > 6 * 3600
        labels: {severity: critical}
        annotations:
          summary: "Aucun snapshot OpenSearch reussi depuis plus de 6 heures"

  - name: graylog-stockage
    rules:
      - alert: OpenSearchClusterRouge
        expr: elasticsearch_cluster_health_status{color="red"} == 1
        for: 1m
        labels: {severity: critical}
        annotations:
          summary: "Cluster OpenSearch ROUGE : des shards primaires sont indisponibles"

      - alert: OpenSearchClusterJaune
        expr: elasticsearch_cluster_health_status{color="yellow"} == 1
        for: 30m
        labels: {severity: warning}
        annotations:
          summary: "Cluster OpenSearch JAUNE depuis 30 minutes (replicas non alloues)"

      - alert: OpenSearchNoeudManquant
        expr: elasticsearch_cluster_health_number_of_nodes < 3
        for: 2m
        labels: {severity: critical}
        annotations:
          summary: "Moins de 3 noeuds OpenSearch dans le cluster"

      - alert: OpenSearchDisque
        expr: elasticsearch_filesystem_data_available_bytes / elasticsearch_filesystem_data_size_bytes < 0.2
        for: 10m
        labels: {severity: warning}
        annotations:
          summary: "Moins de 20 % d'espace libre sur {{ $labels.name }}"

      - alert: MongoDBArrete
        expr: mongodb_up == 0
        for: 2m
        labels: {severity: critical}
        annotations:
          summary: "MongoDB ne repond plus : configuration Graylog inaccessible"
Validez la syntaxe puis rechargez Prometheus :
promtool check config /etc/prometheus/prometheus.yml
promtool check rules /etc/prometheus/rules/graylog.rules.yml
curl -X POST http://localhost:9090/-/reload   # si --web.enable-lifecycle est actif
Étape 9 : router les alertes
# /etc/alertmanager/alertmanager.yml
route:
  receiver: equipe-exploitation
  group_by: [alertname, instance]
  group_wait: 30s
  repeat_interval: 4h
  routes:
    - matchers: [severity="critical"]
      receiver: astreinte
      repeat_interval: 30m

receivers:
  - name: equipe-exploitation
    email_configs:
      - to: exploitation@exemple.local
  - name: astreinte
    email_configs:
      - to: astreinte@exemple.local
    webhook_configs:
      - url: https://passerelle-notifications.exemple.local/alertes

inhibit_rules:
  - source_matchers: [alertname="GraylogNoeudArrete"]
    target_matchers: [severity="warning"]
    equal: [instance]
La règle d'inhibition évite de recevoir dix alertes « warning » quand la cause est simplement un nœud arrêté.
Étape 10 : vérifier que tout est collecté
Après le rechargement de Prometheus, toutes les cibles doivent être « up ». Vérification depuis le serveur Prometheus :
curl -s http://10.0.10.6:9090/api/v1/targets \
  | jq -r '.data.activeTargets[] | "\(.labels.job)  \(.labels.instance)  \(.health)  \(.lastError)"'
Puis, dans l'onglet Graph de Prometheus, contrôlez ces requêtes :
| Requête | Résultat attendu |
|---|---|
up == 0 | Aucun résultat |
count(up{job="graylog"}) | Le nombre de nœuds Graylog (3) |
sum(graylog_node_is_leader) | Exactement 1 |
probe_success{job="graylog_lbstatus"} | 1 pour chaque nœud |
max(gl_journal_size / gl_journal_size_limit) | Inférieur à 0,1 |
max(gl_buffer_usage / gl_buffer_size) | Proche de 0 |
elasticsearch_cluster_health_status{color="green"} | 1 |
time() - opensearch_snapshot_last_success_timestamp_seconds | Inférieur à l'intervalle des snapshots (7200 s pour 2 heures) |
mongodb_up | 1 sur chaque nœud |
Une métrique absente est aussi grave qu'une métrique en alerte : une règle basée sur une série inexistante ne se déclenche jamais. Ajoutez une alerte de sécurité, par exemple absent(gl_journal_size) pendant 10 minutes.
Étape 11 : gérer les cibles par fichiers
Plutôt que de lister les nœuds dans prometheus.yml, déclarez-les dans des fichiers relus automatiquement. Ajouter un nœud Graylog ne demande alors ni redémarrage ni modification de la configuration principale, et le fichier peut être généré par votre outil d'automatisation.
# /etc/prometheus/targets/graylog.yml
- targets: ["gl01.exemple.local:9833", "gl02.exemple.local:9833", "gl03.exemple.local:9833"]
  labels:
    env: production
    cluster: graylog-prod

# Dans prometheus.yml, a la place de static_configs
  - job_name: graylog
    metrics_path: /api/metrics/prometheus
    file_sd_configs:
      - files: ["/etc/prometheus/targets/graylog.yml"]
        refresh_interval: 1m
Étape 12 : règles d'enregistrement
Les règles d'enregistrement précalculent les ratios utilisés partout : les tableaux de bord sont plus rapides et les alertes plus lisibles.
# /etc/prometheus/rules/graylog.recording.yml
groups:
  - name: graylog-recording
    interval: 30s
    rules:
      - record: graylog:journal_utilisation:ratio
        expr: gl_journal_size / gl_journal_size_limit
      - record: graylog:buffer_utilisation:ratio
        expr: gl_buffer_usage / gl_buffer_size
      - record: graylog:trafic_entrant:octets_par_seconde
        expr: sum by (instance) (rate(gl_traffic_input[5m]))
      - record: graylog:cluster_trafic_entrant:octets_par_seconde
        expr: sum(rate(gl_traffic_input[5m]))
Ajoutez le fichier dans rule_files, puis utilisez ces noms dans les alertes, par exemple graylog:journal_utilisation:ratio > 0.8.
Étape 13 : tester les alertes avant la production
promtool sait tester les règles d'alerte avec des séries simulées, sans attendre une vraie panne :
# /etc/prometheus/rules/graylog.tests.yml
rule_files:
  - graylog.rules.yml
evaluation_interval: 1m
tests:
  - interval: 1m
    input_series:
      - series: 'up{job="graylog", instance="gl01.exemple.local:9833"}'
        values: '1 1 0 0 0 0'
    alert_rule_test:
      - eval_time: 5m
        alertname: GraylogNoeudArrete
        exp_alerts:
          - exp_labels:
              severity: critical
              job: graylog
              instance: gl01.exemple.local:9833
            exp_annotations:
              summary: "Graylog ne repond plus sur gl01.exemple.local:9833"
              description: "Service graylog-server arrete ou bloque. Verifier systemctl status graylog-server et server.log."
  - interval: 1m
    input_series:
      - series: 'graylog_node_is_leader{hostname="gl01"}'
        values: '1 0 0 0 0'
      - series: 'graylog_node_is_leader{hostname="gl02"}'
        values: '0 0 0 0 0'
    alert_rule_test:
      - eval_time: 4m
        alertname: GraylogAucunLeader
        exp_alerts:
          - exp_labels:
              severity: critical
            exp_annotations:
              summary: "Aucun noeud leader dans le cluster Graylog"
              description: "Rotation et retention des index arretees : le disque OpenSearch va se remplir."
promtool test rules /etc/prometheus/rules/graylog.tests.yml
# Verifier le routage d'Alertmanager et envoyer une alerte de test
amtool check-config /etc/alertmanager/alertmanager.yml
amtool config routes test --config.file=/etc/alertmanager/alertmanager.yml severity=critical
amtool --alertmanager.url=http://127.0.0.1:9093 alert add alertname=TestSupervision \
severity=critical instance=test --annotation=summary="Alerte de test, a ignorer"La commande routes test doit afficher le destinataire astreinte, et l'alerte de test doit arriver sur la messagerie d'astreinte.
Étape 14 : provisionner Grafana
Déclarez la source de données par fichier, pour qu'une réinstallation de Grafana retrouve sa configuration :
# /etc/grafana/provisioning/datasources/prometheus.yml
apiVersion: 1
datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://10.0.10.6:9090
    isDefault: true
Exploitation : intervenir sans fausses alertes
Avant une maintenance sur un nœud, retirez-le proprement du répartiteur et rendez les alertes silencieuses, puis faites l'inverse à la fin :
# 1. Retirer le noeud du repartiteur : lbstatus passe a DEAD (jeton d'un compte autorise)
curl -s --cacert /etc/prometheus/ca-entreprise.pem -u "$GL_ADMIN_TOKEN:token" \
  -X PUT -H "X-Requested-By: maintenance" \
  https://gl02.exemple.local:9000/api/system/lbstatus/override/dead

# 2. Silence de 2 heures sur toutes les alertes du noeud
amtool --alertmanager.url=http://127.0.0.1:9093 silence add 'instance=~"gl02.*"' \
  --duration=2h --author="exploitation" --comment="Maintenance gl02"

# 3. Cote Nagios : planifier un arret programme du serveur et de ses services
#    (interface web ou commande externe SCHEDULE_HOST_SVC_DOWNTIME)

# 4. Apres l'intervention : remettre le noeud en service
curl -s --cacert /etc/prometheus/ca-entreprise.pem -u "$GL_ADMIN_TOKEN:token" \
  -X PUT -H "X-Requested-By: maintenance" \
  https://gl02.exemple.local:9000/api/system/lbstatus/override/alive
Le forçage de l'état lbstatus est temporaire : un redémarrage du service le remet à son comportement normal. Attendez quelques secondes après le passage en DEAD, le temps que le répartiteur cesse d'envoyer du trafic, avant d'arrêter graylog-server.
Synthèse des seuils applicatifs
| Indicateur | Avertissement | Critique |
|---|---|---|
Nœud Graylog joignable (up) | - | 0 pendant 2 min |
| Nombre de leaders | Plus de 1 pendant 5 min | 0 pendant 2 min |
| lbstatus | - | Autre que ALIVE pendant 1 min |
| Remplissage du journal | 50 % pendant 10 min | 80 % pendant 5 min |
| Messages en attente dans le journal | Plus d'un million et en hausse | - |
| Buffers process et output | 90 % pendant 5 min | - |
| Trafic entrant | Moitié du trafic de la veille | Nul pendant 10 min |
| Heap Java Graylog | 90 % pendant 15 min | - |
| Erreurs d'indexation | Plus de 0 sur 5 min | - |
| Dernière archive Graylog | - | Plus de 26 h |
| Dernier snapshot OpenSearch | - | Plus de 6 h (snapshots toutes les 2 h) |
| Santé OpenSearch | Jaune pendant 30 min | Rouge pendant 1 min |
| Nœuds OpenSearch | - | Moins que prévu |
| Certificats | Expiration dans moins de 21 jours | - |
Tester avant de faire confiance
- Arrêt d'un service :
systemctl stop graylog-serversur un nœud de test. Attendu : Nagios en CRITICAL sur le service, Prometheus déclenche GraylogNoeudArrete et GraylogLbStatusDead. - Perte du leader : arrêter le nœud leader et vérifier qu'un autre nœud reprend le rôle en moins de 2 minutes, sans déclencher GraylogAucunLeader.
- Ralentissement d'OpenSearch : mettre un nœud OpenSearch en pause sur une plateforme de recette et observer la montée du buffer output puis du journal.
- Archivage : suspendre la tâche d'archivage ou de snapshot et vérifier que l'alerte se déclenche au bout du délai prévu.
- Silence des sources : couper un input de test et contrôler l'alerte de trafic.
Tableaux de bord Grafana
Avec ces métriques, un tableau de bord Grafana efficace tient en quatre lignes : état du cluster (nœuds, leader, lbstatus), flux (trafic entrant et sortant, débit par stream), file d'attente (journal, buffers, messages en attente) et stockage (santé OpenSearch, disque, derniers snapshots et archives). Exemples de requêtes :
# Remplissage du journal en %
100 * gl_journal_size / gl_journal_size_limit

# Volume recu par jour et par noeud
increase(gl_traffic_input{job="graylog"}[1d])

# Remplissage des buffers en %
100 * gl_buffer_usage / gl_buffer_size

# Age du dernier snapshot en heures
(time() - opensearch_snapshot_last_success_timestamp_seconds) / 3600
En résumé
Nagios garantit que les serveurs et les services sont en bonne santé ; Prometheus vérifie que Graylog fait réellement son travail : recevoir, traiter, indexer, archiver. Les indicateurs les plus importants sont le journal, qui révèle tout ralentissement avant la perte de messages, la présence d'un leader, l'état d'OpenSearch et la fraîcheur des archives et snapshots. Avec les seuils et la configuration ci-dessus, votre plateforme de journaux ne tombera plus en panne en silence.
BS Core IT Consulting conçoit, déploie et supervise des plateformes Graylog en production, de l'architecture au plan de reprise, et forme vos équipes d'exploitation.