IA souveraine : solutions propriétaires et open source, architecture et matériel
Pourquoi une IA souveraine, quelles offres françaises, européennes et open source choisir, comment bâtir la plateforme et sur quel matériel GPU la faire tourner.
L'IA générative est entrée dans les entreprises, souvent par la petite porte : des collaborateurs qui collent des contrats, du code ou des données clients dans des assistants grand public hébergés hors d'Europe. Pour les organisations qui manipulent des données sensibles, ce n'est pas tenable. L'IA souveraine répond à ce besoin : profiter de l'IA sans perdre la maîtrise de ses données, de ses modèles et de son infrastructure.
Qu'est-ce qu'une IA souveraine ?
Une IA est souveraine lorsque l'organisation garde le contrôle sur quatre plans :
- Les données : requêtes, documents et réponses restent dans un périmètre maîtrisé, sur site ou chez un hébergeur soumis au seul droit européen.
- Les modèles : on sait quel modèle tourne, dans quelle version, et on peut le conserver, le remplacer ou l'adapter sans dépendre d'un fournisseur unique.
- L'infrastructure : serveurs, réseau et stockage sont exploités par l'entreprise ou par un prestataire de confiance qualifié.
- Le droit applicable : aucune loi extraterritoriale (Cloud Act, FISA) ne doit permettre à une autorité étrangère d'accéder aux données.
S'y ajoutent les obligations réglementaires : RGPD, directive NIS2, et l'AI Act européen, entré en vigueur en août 2024, dont les obligations s'appliquent par étapes (modèles à usage général depuis août 2025, autres obligations ensuite, certaines échéances pour les systèmes à haut risque étant en discussion).
Les trois façons de déployer
| Modèle | Principe | Avantages | Limites |
|---|---|---|---|
| Sur site | Serveurs GPU dans votre datacenter | Contrôle total, possibilité de fonctionner isolé d'Internet, coût prévisible à forte utilisation | Investissement initial, compétences, énergie et refroidissement |
| Cloud de confiance | GPU ou service d'IA chez un hébergeur européen, idéalement qualifié SecNumCloud | Démarrage rapide, élasticité, pas de matériel à gérer | Coût à l'usage, offre IA qualifiée encore réduite |
| Hybride | Données les plus sensibles sur site, pics de charge et usages moins sensibles en cloud de confiance | Bon compromis coût et contrôle | Architecture et gouvernance plus riches |
Les solutions propriétaires et commerciales
Éditeurs de modèles et plateformes d'IA
- Mistral AI (France) : modèles performants, dont plusieurs publiés sous licence Apache 2.0, et une suite pour l'entreprise (assistant Le Chat Enterprise, plateforme de développement) déployable dans votre cloud privé ou sur site. En septembre 2026, Mistral et Numspot ont annoncé une offre d'IA managée sur cloud souverain français.
- LightOn (France) : plateforme d'IA générative Paradigm, pensée pour le déploiement privé et la recherche dans les documents de l'entreprise.
- Cohere (Canada) : modèles et plateforme pour l'entreprise, avec des déploiements privés.
Socles logiciels pour héberger l'IA
- VMware Private AI Foundation with NVIDIA : l'IA générative intégrée à VMware Cloud Foundation, avec GPU virtualisés, catalogue de modèles et services de base vectorielle. Idéal pour les organisations déjà sur VMware.
- Red Hat OpenShift AI : plateforme Kubernetes pour entraîner, servir et superviser les modèles, avec un moteur d'inférence fondé sur vLLM.
- NVIDIA AI Enterprise : pilotes, conteneurs de modèles optimisés (NIM) et outils, supportés sur les principales plateformes.
Cloud de confiance
La qualification SecNumCloud de l'ANSSI est la référence française pour un cloud protégé des lois extraterritoriales. Fin octobre 2026, parmi les prestataires qualifiés ou annonçant l'être sur au moins une offre : 3DS Outscale, OVHcloud, Cloud Temple, S3NS et Numspot. Bleu et Scaleway sont en cours de qualification. Point d'attention : la qualification porte sur un périmètre précis, et les offres d'IA ou de GPU qualifiées restent rares. Vérifiez toujours le catalogue à jour de l'ANSSI et le périmètre exact. Les services d'IA managés d'OVHcloud (AI Endpoints) ou de Scaleway (Generative APIs) offrent un hébergement européen, hors périmètre qualifié à ce jour.
Les briques open source
Les modèles à poids ouverts
| Famille | Éditeur | Licence | Remarques |
|---|---|---|---|
| Mistral (Small, Large) | Mistral AI, France | Apache 2.0 pour les modèles ouverts | Excellents en français, choix naturel pour la souveraineté |
| gpt-oss (20B, 120B) | OpenAI | Apache 2.0 | Le 120B tient sur un seul GPU de 80 Go grâce à sa quantification |
| Qwen | Alibaba | Apache 2.0 (la plupart) | Très large gamme de tailles, bon en code |
| Gemma | Licence ouverte | Modèles compacts et efficaces | |
| DeepSeek | DeepSeek | MIT | Très gros modèles à mélange d'experts, exigeants en matériel |
| Llama | Meta | Licence communautaire | Restrictions pour les entreprises de l'UE sur certains modèles : faire valider juridiquement |
« Poids ouverts » ne signifie pas toujours « open source » au sens strict : les données d'entraînement sont rarement publiées. Ce qui compte pour la souveraineté : pouvoir télécharger le modèle, l'exécuter chez soi et l'utiliser commercialement. Lisez chaque licence. L'origine du modèle et les biais éventuels doivent aussi être évalués sur vos propres cas d'usage.
Le reste de la chaîne
| Fonction | Outils open source |
|---|---|
| Inférence en production | vLLM, SGLang (forte charge, nombreux utilisateurs simultanés) |
| Inférence légère | Ollama, llama.cpp (poste de travail, tests, petits serveurs) |
| Passerelle et routage | LiteLLM (API unique, clés, quotas, journalisation) |
| Interface utilisateur | Open WebUI, LibreChat |
| RAG et agents | Dify, LangChain, LlamaIndex |
| Base vectorielle | Qdrant, Milvus, pgvector (PostgreSQL), OpenSearch |
| Observabilité | Langfuse (traces, coûts, qualité), Prometheus et Grafana (GPU) |
L'État français montre la voie avec Albert, l'IA des agents publics, construite sur des modèles ouverts et des briques open source hébergées dans un périmètre maîtrisé.
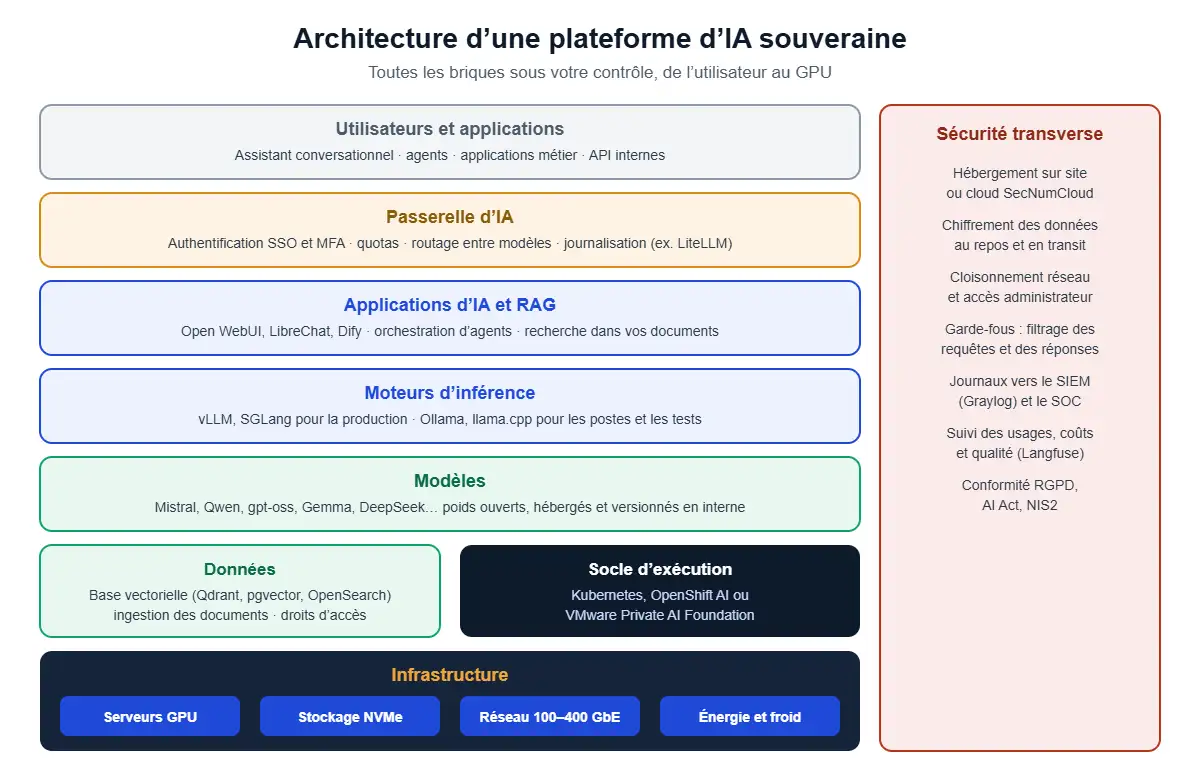
Monter la plateforme, étape par étape
- Choisir les cas d'usage : assistant interne, recherche dans la documentation, aide au code, analyse de contrats, support client. Ils déterminent la taille des modèles et la charge.
- Classer les données : publiques, internes, confidentielles, réglementées. Ce classement décide de ce qui peut aller en cloud de confiance et de ce qui reste sur site.
- Choisir le socle : Kubernetes (ou OpenShift AI), VMware Private AI Foundation si votre datacenter est sous VCF, ou un simple serveur pour un pilote.
- Déployer l'inférence : vLLM avec un ou deux modèles choisis après des tests sur vos propres questions, en français.
- Ajouter la passerelle : authentification par SSO et MFA, quotas par équipe, journalisation de toutes les requêtes.
- Brancher vos documents (RAG) : ingestion, découpage, base vectorielle, et surtout respect des droits d'accès : un utilisateur ne doit retrouver que les documents qu'il a le droit de lire.
- Sécuriser et superviser : garde-fous sur les entrées et sorties, protection contre l'injection de requêtes, journaux envoyés au SIEM et au SOC, suivi de la qualité des réponses.
- Accompagner les utilisateurs : charte d'usage, formation, retour d'expérience pour améliorer les prompts et les sources.
Quel matériel ?
Estimer la mémoire GPU nécessaire
Le critère numéro un est la mémoire du GPU. Une règle simple : mémoire des poids = nombre de paramètres × octets par paramètre (2 en FP16, 1 en FP8, environ 0,5 en quantification 4 bits), plus 20 à 50 % pour le contexte des conversations (cache KV), qui grandit avec le nombre d'utilisateurs simultanés et la longueur des documents.
- Un modèle de 24 milliards de paramètres en FP8 : environ 24 Go de poids, à l'aise sur une carte de 48 Go.
- Un modèle de 70 milliards en FP8 : environ 70 Go de poids, donc un GPU de 141 Go ou deux de 80 Go.
- gpt-oss-120b, déjà quantifié : un seul GPU de 80 Go.
Les principales cartes
| GPU | Mémoire | Usage type |
|---|---|---|
| NVIDIA L40S | 48 Go | Inférence de modèles petits et moyens, serveurs standards |
| NVIDIA RTX PRO 6000 Blackwell | 96 Go | Excellent rapport capacité et prix pour l'inférence |
| NVIDIA H100 / H200 | 80 / 141 Go | Production, gros modèles, nombreux utilisateurs |
| NVIDIA B200 / B300 | Environ 180 / 288 Go | Très gros modèles, entraînement et fine-tuning |
| AMD Instinct MI300X / MI325X / MI355X | 192 / 256 / 288 Go | Alternative à NVIDIA, grande mémoire, écosystème ROCm |
| NVIDIA DGX Spark, Apple Mac Studio | 128 Go à 512 Go de mémoire unifiée | Laboratoire, pilote, petite équipe (débit limité) |
Trois configurations types
| Pilote | Département | Entreprise | |
|---|---|---|---|
| Utilisateurs | 5 à 30 | 50 à 500 | 500 et plus |
| Matériel | 1 station ou serveur avec 1 à 2 GPU de 48 à 96 Go | 1 à 2 serveurs avec 4 GPU (L40S, RTX PRO 6000 ou H100) | Plusieurs serveurs avec 8 GPU H200, B200 ou MI325X/MI355X, redondance |
| Modèles | Jusqu'à 30 milliards de paramètres, quantifiés | 70 à 120 milliards | Grands modèles et plusieurs modèles spécialisés |
| Logiciel | Ollama ou vLLM, Open WebUI | vLLM, LiteLLM, RAG, Kubernetes | Plateforme complète, haute disponibilité, MLOps |
Ne pas oublier l'environnement
- Énergie et refroidissement : un serveur à 8 GPU haut de gamme consomme plus de 10 kW ; vérifiez la capacité de vos baies, voire le refroidissement liquide pour les générations récentes.
- Réseau : 100 à 400 GbE entre serveurs GPU, et InfiniBand ou Ethernet RoCE si un modèle est réparti sur plusieurs serveurs.
- Stockage : NVMe rapide pour charger les modèles (plusieurs centaines de gigaoctets) et héberger la base vectorielle.
- Délais d'approvisionnement : les GPU les plus demandés peuvent prendre plusieurs mois ; commencez par le cloud de confiance si besoin.
Les pièges à éviter
- Choisir le plus gros modèle par principe : un modèle moyen bien servi, avec de bons documents, bat souvent un très gros modèle lent.
- Négliger les droits d'accès dans le RAG : c'est la première source de fuite d'information interne.
- Oublier les journaux : sans traçabilité des requêtes, impossible d'enquêter ou de démontrer la conformité.
- Laisser l'IA « fantôme » prospérer : si l'offre interne est moins pratique que les outils grand public, les utilisateurs continueront à y coller des données sensibles.
- Sous-estimer l'exploitation : mises à jour des modèles et des moteurs, supervision des GPU, gestion de la capacité.
En résumé
L'IA souveraine est aujourd'hui accessible : des modèles ouverts de grande qualité, dont des modèles français, des logiciels open source mûrs et une offre matérielle variée permettent de bâtir une plateforme performante, sur site ou en cloud de confiance. La réussite tient à une démarche progressive : cas d'usage ciblés, classement des données, pilote mesuré, puis industrialisation avec une sécurité intégrée dès le départ.
BS Core IT Consulting, spécialiste de l'IA souveraine et des architectures d'infrastructure, vous accompagne de l'étude d'opportunité à la mise en production : choix des modèles et du matériel, conception de la plateforme (y compris sur VMware Cloud Foundation), sécurisation et formation de vos équipes.