Colibri : faire tourner des modèles d'IA géants sur un PC ordinaire
Colibri, moteur d'inférence open source en C, exécute GLM-5.2 (744 milliards de paramètres) avec 25 Go de RAM en lisant les experts sur disque. Fonctionnement, matériel, installation, performances et limites.
Faire tourner chez soi un modèle de langage de plusieurs centaines de milliards de paramètres demandait jusqu'ici des serveurs à plusieurs GPU et des centaines de gigaoctets de mémoire. En juillet 2026, un projet open source a bousculé cette idée : Colibri (parfois écrit Colibrì) exécute GLM-5.2, un modèle de 744 milliards de paramètres, sur un PC doté d'environ 25 Go de RAM et sans carte graphique.
Lent, certes. Mais la démonstration est importante pour tous ceux qui s'intéressent à l'IA souveraine : les très grands modèles ouverts deviennent accessibles hors ligne, sur du matériel ordinaire. Cet article explique ce qu'est Colibri, comment il fonctionne, comment l'installer et dans quels cas l'utiliser.
Colibri en bref
| Point | Détail |
|---|---|
| Nature | Moteur d'inférence pour grands modèles à mélange d'experts (MoE) |
| Auteur | Vincenzo Fornaro (compte GitHub JustVugg) |
| Licence | Apache 2.0 pour le moteur ; chaque modèle garde sa propre licence (GLM-5.2 est sous licence MIT) |
| Langage | C pur, un fichier par famille de modèles, sans Python pendant l'inférence |
| Première publication | Juillet 2026, pour GLM-5.2 |
| Plateformes | Linux, Windows 10/11, macOS (WSL possible) |
| GPU | Optionnel : Vulkan (AMD, Intel, NVIDIA), CUDA, Metal |
| Interfaces | Ligne de commande, tableau de bord web, API compatible OpenAI et Anthropic, serveur MCP |
Pourquoi c'est possible : le mélange d'experts
Les grands modèles récents (GLM, DeepSeek, Qwen, Kimi…) sont construits en mélange d'experts. Au lieu d'un seul réseau géant entièrement sollicité à chaque mot, ils comportent des milliers de petits sous-réseaux, les experts, et un routeur qui n'en choisit que quelques-uns pour chaque mot généré. Sur les 744 milliards de paramètres de GLM-5.2, seuls environ 40 milliards travaillent à chaque étape.
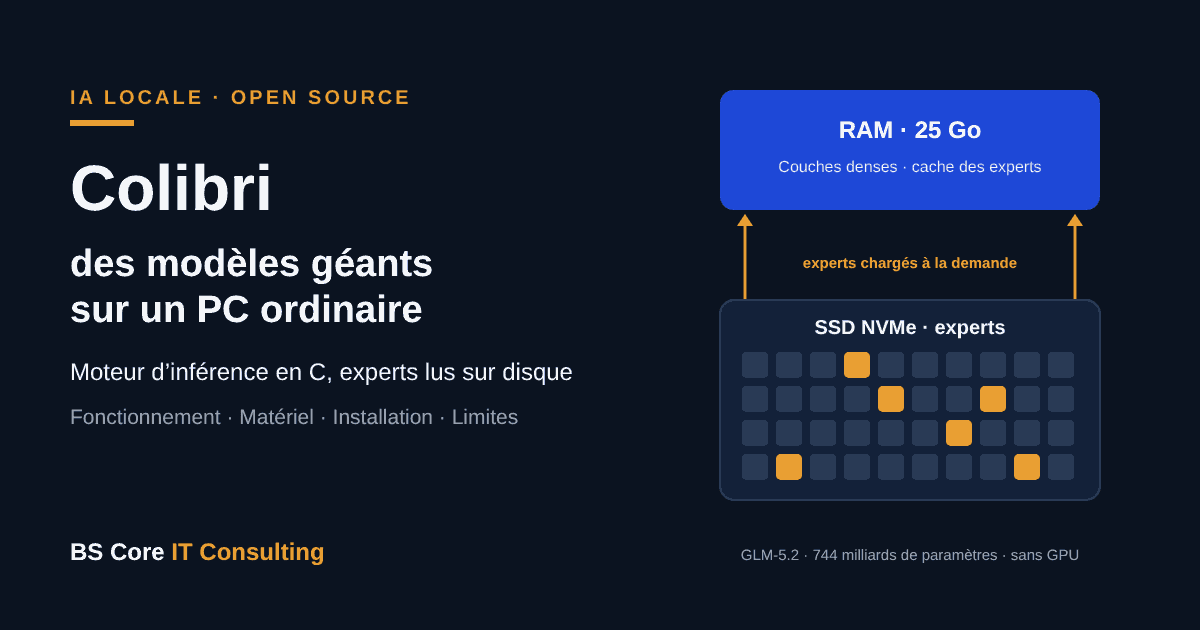
L'idée de Colibri découle de ce constat : inutile de tout charger en mémoire. Il suffit de garder en RAM ce qui sert tout le temps et d'aller chercher sur le disque les experts choisis par le routeur.
Comment fonctionne Colibri
| Où | Quoi | Taille pour GLM-5.2 |
|---|---|---|
| RAM | Partie dense : attention, embeddings, experts partagés (environ 17 milliards de paramètres, quantifiés en 4 bits) | Environ 9,9 Go |
| RAM | Cache des experts : LRU par couche, plus un jeu d'experts « chauds » appris à l'usage et préchargés au démarrage | Selon la RAM disponible |
| GPU (optionnel) | Couches denses et experts les plus utilisés | Selon la VRAM |
| SSD NVMe | Les 21 504 experts routés, lus à la demande | Environ 370 Go |
Plusieurs optimisations rendent l'approche utilisable :
- Une lecture par expert : les trois matrices d'un expert sont lues en un seul accès disque.
- Lecture en parallèle du calcul : un groupe de threads charge les experts manquants pendant que les experts déjà en mémoire calculent.
- Préchargement anticipé : le projet indique que le routage de GLM-5.2 est prévisible une couche à l'avance dans 71,6 % des cas, ce qui permet de lire les experts avant d'en avoir besoin.
- Décodage spéculatif : la tête de prédiction multi-jetons (MTP) de GLM-5.2 propose 2,2 à 2,8 jetons par passe quand le cache est chaud.
- Cache de contexte compact : l'attention MLA de GLM-5.2 stocke 576 valeurs par jeton au lieu de 32 768, soit 57 fois moins, et ce cache survit aux redémarrages.
- Mise à l'échelle : lecture sur deux disques NVMe (+37,5 % mesurés), répartition sur les contrôleurs mémoire (NUMA), et même un mode grappe qui envoie les experts sur d'autres machines.
Les modèles pris en charge
Parti de GLM-5.2, le projet a rapidement grandi. Il annonce aujourd'hui dix moteurs pour les modèles de langage, dont :
- GLM-5.2, GLM-5.3 et GLM-5.3-Flash (Z.ai) ;
- DeepSeek V4 Flash et V4.1 Flash ;
- Qwen3.6, Qwen3-Coder, Qwen3.8-Flash-Next et le modèle dense Qwen3.8-27B ;
- Kimi K3, MiMo-V2.6 Flash et Pro, Inkling, OLMoE.
S'y ajoutent un modèle de génération d'images (Qwen-Image-2.1, réservé à un usage non commercial) et des modèles de décision. La liste évolue vite : consultez le dépôt avant de choisir.
Quel matériel ?
Configuration minimale et recommandée
- RAM : 8 Go minimum pour le plus petit modèle, 16 Go ou plus recommandés. Pour GLM-5.2 : 16 Go minimum, 24 Go et plus conseillés, et plus vous en avez, plus le cache d'experts est efficace.
- Disque : un SSD NVMe rapide est le facteur numéro un. Comptez environ 430 Go pour GLM-5.2 en 4 bits ; les modèles vont de 19 Go (Qwen3-Coder) à 1,56 To (Kimi K3).
- Processeur : un CPU x86_64 récent avec AVX2, ou ARM64 (Apple Silicon, ou Linux ARM en compilant depuis les sources).
- GPU : facultatif, mais il accélère nettement les petits et moyens modèles.
Performances publiées par le projet
| Machine | Modèle | Vitesse de génération |
|---|---|---|
| PC portable, 25 Go de RAM, cache vide | GLM-5.2 | 0,05 à 0,1 jeton/s |
| Ryzen AI Max+ 395, 128 Go | GLM-5.2 | 1,83 jeton/s |
| 6 × RTX 5090, tous les experts en mémoire | GLM-5.2 | 9 à 9,2 jetons/s |
| Ryzen 7 5800X, 32 Go | DeepSeek V4 Flash | 0,93 jeton/s |
| RTX 5080 (CUDA) | DeepSeek V4 Flash | 1,5 à 1,6 jeton/s |
| Ryzen 7 PRO 8700GE, 64 Go, GPU intégré (Vulkan) | Qwen3.6 | 9,9 jetons/s |
| RTX 3070 8 Go (CUDA) | Qwen3.6 | 30 jetons/s |
| Processeur seul | OLMoE | 22 à 23 jetons/s |
Ces chiffres sont ceux publiés par le projet et ses utilisateurs, souvent mesurés sur une seule machine : testez sur votre propre matériel. Pour situer : un échange confortable demande au moins 10 à 20 jetons par seconde. Avec GLM-5.2 sur un PC modeste, une réponse courte peut prendre plusieurs minutes, puisqu'environ 11 Go doivent être lus sur le disque pour chaque jeton quand le cache est vide.
Installation
En une étape
Le script d'installation détecte le matériel, recommande un modèle adapté, compile le moteur, télécharge le modèle (téléchargement reprenable) et ouvre le tableau de bord :
git clone https://github.com/JustVugg/colibri.git
cd colibri
./start-here.sh          # Windows : START-HERE.bat

./start-here.sh --list         # modèles adaptés à la machine
./start-here.sh --reconfigure  # changer de modèle
c/coli status                  # état
c/coli stop                    # arrêt
Pas à pas, sous Linux
# 1. Outils de compilation
sudo apt update
sudo apt install -y build-essential git python3

# 2. Compilation et auto-test
git clone https://github.com/JustVugg/colibri.git
cd colibri/c
./setup.sh

# 3. Modèle : conteneur 4 bits prêt à l'emploi (environ 429 Go),
#    ou conversion depuis la version FP8, morceau par morceau
./coli convert --model /nvme/glm52_i4

# 4. Utilisation
COLI_MODEL=/nvme/glm52_i4 ./coli doctor   # vérifier la configuration
COLI_MODEL=/nvme/glm52_i4 ./coli plan     # répartition RAM / disque / GPU
COLI_MODEL=/nvme/glm52_i4 ./coli chat     # conversation
Conseil pour WSL : gardez les modèles sur le disque Linux (par défaut ~/colibri-models), pas sous /mnt/c, qui est beaucoup plus lent.
Brancher vos applications
Avec coli serve, Colibri expose une API compatible OpenAI sur http://127.0.0.1:8000/v1 (/chat/completions, /completions, /models), ainsi qu'un point d'accès compatible Anthropic. Il suffit de changer l'adresse de base dans vos outils : Open WebUI, scripts Python, agents. L'appel d'outils est pris en charge sur la plupart des modèles, et jusqu'à 16 conversations isolées peuvent coexister.
Colibri face aux autres moteurs
| Colibri | llama.cpp / Ollama | vLLM / SGLang | |
|---|---|---|---|
| Objectif | Très grands modèles MoE sur peu de RAM | Modèles petits et moyens sur poste ou serveur | Production, nombreux utilisateurs |
| Matériel type | PC avec SSD NVMe rapide, GPU facultatif | CPU, GPU grand public, Mac | Serveurs GPU avec beaucoup de VRAM |
| Débit | Faible à moyen | Moyen | Élevé |
| Maturité | Projet très récent | Très mature | Mature, standard de l'industrie |
| Usage idéal | Expérimentation, traitements différés, environnements isolés | Assistant local, développement | Plateforme d'entreprise |
Pour quels usages en entreprise ?
- Évaluer les grands modèles ouverts sur vos propres cas d'usage, en interne et sans envoyer de données à l'extérieur, avant d'investir dans des serveurs GPU.
- Environnements isolés d'Internet : laboratoires, sites sensibles, valises de démonstration ou d'audit.
- Traitements par lots la nuit : résumés de documents, classification, extraction, où la vitesse compte moins que la qualité et la confidentialité.
- Recherche et formation : comprendre concrètement le fonctionnement des modèles à mélange d'experts.
En revanche, Colibri n'est pas fait pour un assistant interactif utilisé par des dizaines de collaborateurs : pour cela, une plateforme GPU avec vLLM reste la bonne réponse.
Limites et précautions
- Vitesse : avec les très gros modèles et peu de RAM, la génération est très lente, surtout à froid.
- Qualité : la quantification en 4 bits dégrade légèrement les réponses ; le projet signale que certains formats perdent davantage que d'autres. Mesurez sur vos cas d'usage.
- Usure et charge du SSD : la lecture est intensive et continue ; préférez des disques d'entreprise dédiés.
- Maturité : projet récent, porté principalement par une personne, qui évolue très vite. Figez une version testée plutôt que de suivre la branche principale.
- Sécurité : relisez le code avant un usage sensible, exécutez-le dans un environnement cloisonné, laissez l'API écouter uniquement en local ou derrière une passerelle authentifiée, et vérifiez l'intégrité des modèles téléchargés.
- Licences : le moteur est sous Apache 2.0, mais chaque modèle a sa propre licence, parfois restrictive. Validez-les avant tout usage commercial.
En résumé
Colibri démontre qu'un modèle de 744 milliards de paramètres peut tourner sur un PC ordinaire, sans GPU, en exploitant intelligemment le mélange d'experts et la vitesse des SSD NVMe. Ce n'est pas encore un outil de production, mais c'est une avancée importante pour l'IA souveraine : les meilleurs modèles ouverts deviennent testables et utilisables hors ligne, sur du matériel accessible, sans qu'aucune donnée ne quitte l'entreprise.
BS Core IT Consulting vous aide à évaluer ces nouvelles approches, à choisir entre IA locale, serveurs GPU et cloud de confiance, et à construire une plateforme d'IA souveraine adaptée à vos besoins et à votre budget.
Sources : dépôt GitHub JustVugg/colibri (README et guide de démarrage), article de GIGAZINE du 10 juillet 2026.