Les logs, carburant du SOC : de la collecte à l'alerte, avec des cas concrets
Quels logs collecter, comment les transmettre, les analyser et les exploiter au SOC pour détecter les attaques. Et pourquoi sans politique de collecte, la sécurité reste aveugle.
Un SOC ne détecte que ce qu'il voit. Pare-feu, EDR, SIEM, analystes expérimentés : tout ce dispositif repose sur une matière première souvent sous-estimée, les journaux d'événements. Une connexion réussie après une rafale d'échecs, un compte ajouté aux administrateurs du domaine, une commande qui supprime les sauvegardes : chaque étape d'une attaque laisse une trace, à condition qu'elle soit enregistrée, collectée et analysée.
Cet article parcourt la chaîne complète, de la source jusqu'à l'alerte, illustrée par des cas concrets. Il montre surtout pourquoi, sans politique de collecte efficace et adaptée à votre contexte, on obtient un système de cybersécurité inefficace, aussi coûteux soit-il.
Pourquoi les logs sont au cœur de la cybersécurité
- Détecter : repérer une attaque en cours, idéalement avant qu'elle n'atteigne son objectif.
- Investiguer : reconstituer le scénario d'un incident, identifier le point d'entrée, les comptes et les machines touchés.
- Prouver : disposer d'éléments fiables pour l'assurance, les autorités ou une procédure judiciaire.
- Se conformer : répondre aux exigences réglementaires et contractuelles de traçabilité (secteur financier, opérateurs d'importance vitale, données personnelles, normes ISO 27001 ou PCI DSS).
Les attaquants restent souvent présents plusieurs semaines dans un réseau avant d'être découverts. Sans historique de logs suffisant, l'enquête s'arrête là où la conservation s'arrête.
La chaîne complète : du log brut à l'alerte
Une détection efficace repose sur cinq maillons. Il suffit qu'un seul soit défaillant pour que le SOC devienne aveugle.
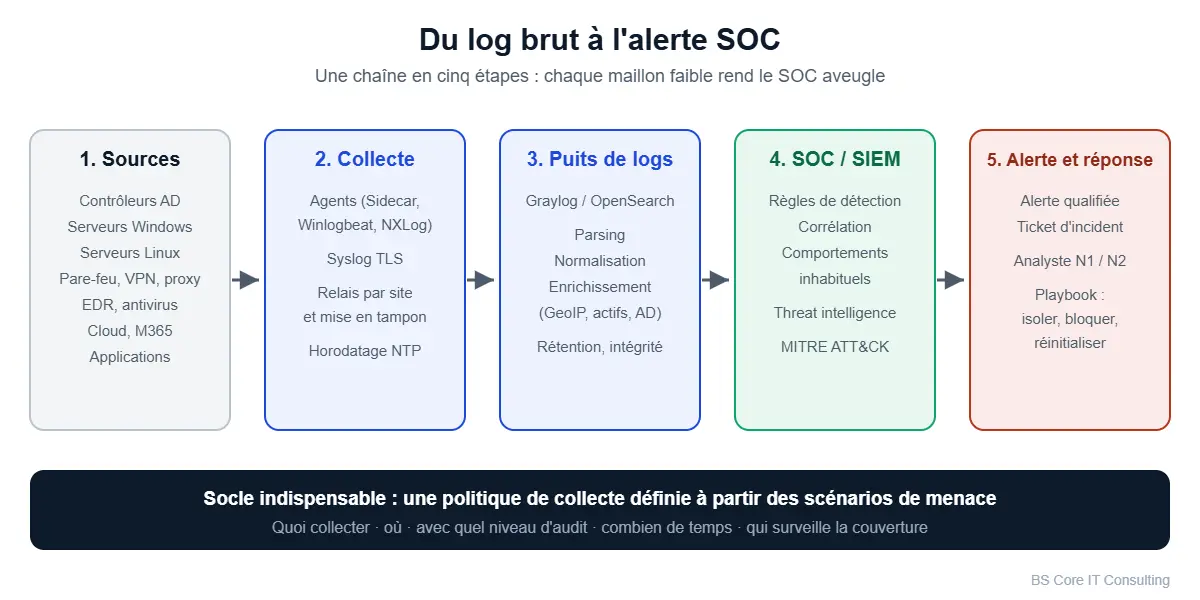
1. Les sources : quels logs collecter ?
| Source | Événements clés | Ce qu'ils permettent de détecter |
|---|---|---|
| Contrôleurs de domaine (Active Directory) | 4624/4625 (connexions), 4740 (verrouillage), 4768/4769 (Kerberos), 4720 (création de compte), 4728/4732/4756 (ajout à un groupe), 4672 (privilèges spéciaux) | Force brute, comptes compromis, élévation de privilèges, attaques Kerberos |
| Serveurs et postes Windows | 4688 (création de processus avec ligne de commande), 7045 (service installé), 4698 (tâche planifiée), 1102 (journal effacé), PowerShell 4104, Sysmon | Exécution malveillante, persistance, effacement de traces, préparation de rançongiciel |
| Serveurs Linux | auth.log / secure (SSH, sudo), auditd, modification des comptes et des clés SSH | Accès non autorisés, élévation de privilèges, persistance |
| Pare-feu, VPN, proxy, DNS | Flux autorisés et bloqués, connexions VPN, requêtes web et DNS | Communication avec un serveur de commande, exfiltration, connexions VPN suspectes |
| EDR et antivirus | Détections, quarantaines, désactivation de l'agent | Logiciels malveillants, tentative de neutralisation des défenses |
| Cloud et messagerie (Microsoft 365, Entra ID…) | Journaux de connexion et d'audit, règles de transfert de messagerie | Hameçonnage réussi, prise de contrôle de boîte mail, connexions depuis l'étranger |
| Virtualisation et sauvegarde | Connexions à vCenter et aux hyperviseurs, suppression de machines ou de sauvegardes | Attaques visant directement l'infrastructure et les capacités de restauration |
| Applications métier | Authentifications, actions d'administration, exports massifs | Fraude, abus de droits, fuite de données |
Attention : beaucoup de ces événements ne sont pas activés par défaut. Sous Windows, la création de processus et sa ligne de commande, ou la journalisation PowerShell, doivent être activées explicitement par stratégie de groupe (stratégie d'audit avancée).
2. La transmission vers le puits de logs
- Agents de collecte sur les serveurs (Graylog Sidecar, Winlogbeat, NXLog, rsyslog) ou envoi syslog natif pour les équipements réseau.
- Transport chiffré (TLS) et authentifié : les logs contiennent des informations sensibles et un attaquant aurait intérêt à les intercepter ou à les falsifier.
- Relais par site avec mise en tampon : en cas de coupure réseau, les événements sont conservés localement puis transmis, sans perte.
- Horloges synchronisées (NTP) sur toutes les sources : sans horodatage fiable, impossible de corréler les événements ou de reconstituer une chronologie.
3. Le puits de logs : analyse et parsing
Un log brut est difficilement exploitable. La plateforme de centralisation (par exemple Graylog adossé à OpenSearch) le transforme en information structurée :
- Parsing : extraction des champs utiles (utilisateur, adresse IP, machine, action, résultat).
- Normalisation : des noms de champs communs à toutes les sources, pour qu'une même règle s'applique au pare-feu, au VPN et à l'Active Directory.
- Enrichissement : géolocalisation des adresses IP, criticité de l'actif, service propriétaire, appartenance du compte à un groupe sensible.
- Réduction du bruit : filtrage des événements sans valeur pour la sécurité, afin de maîtriser volumes et coûts.
- Conservation et intégrité : durée de rétention adaptée à chaque catégorie, accès restreint, protection contre la modification.
Log brut (pare-feu) :
date=2026-10-31 time=08:41:02 srcip=203.0.113.45 dstip=10.10.20.15 dstport=443 action=deny

Après parsing, normalisation et enrichissement :
source_ip=203.0.113.45   source_geo_country=XX   destination_ip=10.10.20.15
destination_port=443     event_action=deny        asset_name=srv-vpn-01
asset_criticality=haute  perimetre=reseau
4. La transmission au SOC
Le SOC, interne ou externalisé, reçoit les événements de sécurité déjà normalisés et enrichis, dans son SIEM ou directement dans la plateforme de logs. Bonne pratique : dédier un flux « sécurité » aux événements utiles à la détection, plutôt que de transmettre la totalité des journaux techniques. Le SOC gagne en lisibilité, et la facture de licence ou de stockage reste maîtrisée.
5. Détection et alerting
- Règles de détection fondées sur des scénarios d'attaque réels, idéalement rattachées au référentiel MITRE ATT&CK.
- Corrélation d'événements issus de plusieurs sources : un échec VPN seul n'est rien, mais suivi d'une connexion réussie puis d'un accès à un serveur sensible, il devient un signal.
- Détection d'anomalies : connexion à une heure ou depuis un pays inhabituel, volume de données sortant anormal.
- Alertes qualifiées avec un niveau de criticité, le contexte nécessaire à l'analyste et un playbook de réponse : isoler la machine, bloquer l'adresse IP, réinitialiser le compte.
Cas concrets de détection
Cas 1 : force brute et pulvérisation de mots de passe
Scénario : un attaquant teste quelques mots de passe courants sur des centaines de comptes, via le VPN ou le portail de messagerie.
Logs nécessaires : échecs de connexion (4625 sur les contrôleurs de domaine, journaux du VPN et du fournisseur d'identité), connexions réussies (4624).
Règle : plus de 20 comptes différents en échec depuis une même adresse IP en 10 minutes, puis une connexion réussie depuis cette adresse. Alerte élevée, blocage de l'adresse et réinitialisation du compte concerné.
Cas 2 : préparation d'un rançongiciel
Scénario : avant de chiffrer, l'attaquant supprime les copies de sauvegarde Windows, installe un service pour se propager et efface les journaux.
Logs nécessaires : 4688 avec ligne de commande (vssadmin delete shadows, wbadmin delete catalog, bcdedit), 7045 (nouveau service), 1102 (journal de sécurité effacé), alertes EDR.
Règle : n'importe lequel de ces événements sur un serveur déclenche une alerte critique ; plusieurs en quelques minutes justifient l'isolement immédiat de la machine par l'EDR. C'est souvent la dernière occasion d'arrêter l'attaque avant le chiffrement.
Cas 3 : élévation de privilèges dans l'Active Directory
Scénario : un compte compromis est ajouté au groupe « Admins du domaine ».
Logs nécessaires : 4728, 4732 et 4756 (ajout d'un membre à un groupe de sécurité), enrichis avec la liste des groupes sensibles.
Règle : tout ajout à un groupe à privilèges hors d'une demande de changement approuvée déclenche une alerte. Simple, peu bruyante et redoutablement efficace.
Cas 4 : attaque Kerberoasting
Scénario : l'attaquant demande des tickets Kerberos pour des comptes de service afin de casser leur mot de passe hors ligne.
Logs nécessaires : 4769 (demande de ticket de service) sur les contrôleurs de domaine.
Règle : un même compte qui demande en peu de temps des tickets pour de nombreux services, ou avec un chiffrement faible (RC4), est suspect.
Cas 5 : compte de messagerie compromis
Scénario : après un hameçonnage, l'attaquant se connecte à la boîte mail d'un collaborateur et crée une règle qui transfère les messages vers l'extérieur.
Logs nécessaires : journaux de connexion et d'audit de la messagerie en ligne.
Règle : connexion depuis un pays jamais vu pour cet utilisateur, ou deux connexions géographiquement incompatibles en peu de temps (« voyage impossible »), suivie de la création d'une règle de transfert externe.
Cas 6 : exfiltration de données
Scénario : des données sont envoyées vers un service de stockage externe ou dissimulées dans des requêtes DNS.
Logs nécessaires : pare-feu, proxy et DNS, enrichis avec la réputation des destinations.
Règle : volume sortant très supérieur à la normale pour une machine, destination jamais contactée, ou requêtes DNS anormalement longues et nombreuses vers un même domaine.
Sans politique de collecte, la cybersécurité reste aveugle
Un SIEM sans politique de collecte, c'est une alarme dont la moitié des détecteurs ne sont pas branchés : l'investissement est là, la protection ne l'est pas.
Dans la pratique, les mêmes défaillances reviennent :
- Audit non activé : la stratégie d'audit par défaut de Windows ne journalise ni les lignes de commande ni PowerShell. Le cas 2 devient alors indétectable.
- Sources oubliées : l'hyperviseur, la console de sauvegarde ou le VPN ne remontent rien, alors que ce sont des cibles prioritaires.
- Logs collectés mais non exploités : les événements arrivent bruts, sans parsing ni normalisation ; aucune règle ne peut s'appliquer.
- Tout collecter sans tri : le volume explose, les coûts aussi, et les événements importants se noient dans le bruit.
- Conservation trop courte : une attaque découverte après six semaines ne peut pas être reconstituée si les journaux ne sont gardés que trente jours.
- Sources silencieuses non surveillées : un agent arrêté ou un équipement qui n'envoie plus rien passe inaperçu pendant des mois. L'attaquant, lui, sait désactiver la journalisation.
- Horloges désynchronisées : la corrélation entre sources devient impossible.
Une politique de collecte générique, copiée d'un modèle, ne suffit pas non plus : elle doit refléter vos actifs critiques, vos métiers et les menaces qui pèsent réellement sur votre organisation.
Construire une politique de collecte efficace
- Partir des risques : identifier les actifs critiques et les scénarios d'attaque à détecter en priorité (rançongiciel, compromission de comptes, fuite de données).
- En déduire les sources et les événements nécessaires à chaque scénario, en s'appuyant sur MITRE ATT&CK.
- Configurer l'audit sur chaque type de source (stratégies de groupe Windows, auditd, niveaux de journalisation des équipements).
- Définir le transport : agents, chiffrement, relais, synchronisation des horloges.
- Normaliser et enrichir dès l'arrivée dans le puits de logs.
- Fixer la conservation par catégorie, selon les besoins d'investigation et les obligations légales.
- Surveiller la couverture : alerte automatique sur toute source silencieuse, inventaire des actifs comparé aux sources réellement collectées.
- Réviser régulièrement : nouveaux systèmes, nouvelles menaces, retours d'incidents et exercices de simulation d'attaque.
Les indicateurs à suivre
- Taux de couverture des actifs critiques par la collecte.
- Délai d'ingestion entre l'événement et sa disponibilité pour le SOC.
- Nombre de sources silencieuses et délai de rétablissement.
- Temps moyen de détection et de réponse (MTTD et MTTR).
- Taux de faux positifs par règle, pour ajuster la détection sans épuiser les analystes.
En résumé
Les logs sont le carburant du SOC. Bien choisis, transmis de façon fiable, analysés et enrichis, ils permettent de détecter une force brute, une élévation de privilèges ou la préparation d'un rançongiciel à temps pour agir. Mal choisis ou mal exploités, ils donnent une illusion de sécurité : des outils coûteux, mais un SOC aveugle au moment où il faudrait voir.
La différence se joue dès la conception, avec une politique de collecte construite à partir de vos risques. BS Core IT Consulting vous accompagne pour la définir, déployer votre plateforme de logs, écrire vos règles de détection et former vos équipes.