Architecture Graylog en production
Concevoir une plateforme Graylog prête pour la production : cluster de 3 nœuds, OpenSearch répliqué, un input et un stream par périmètre, sécurité, sauvegarde et dimensionnement.
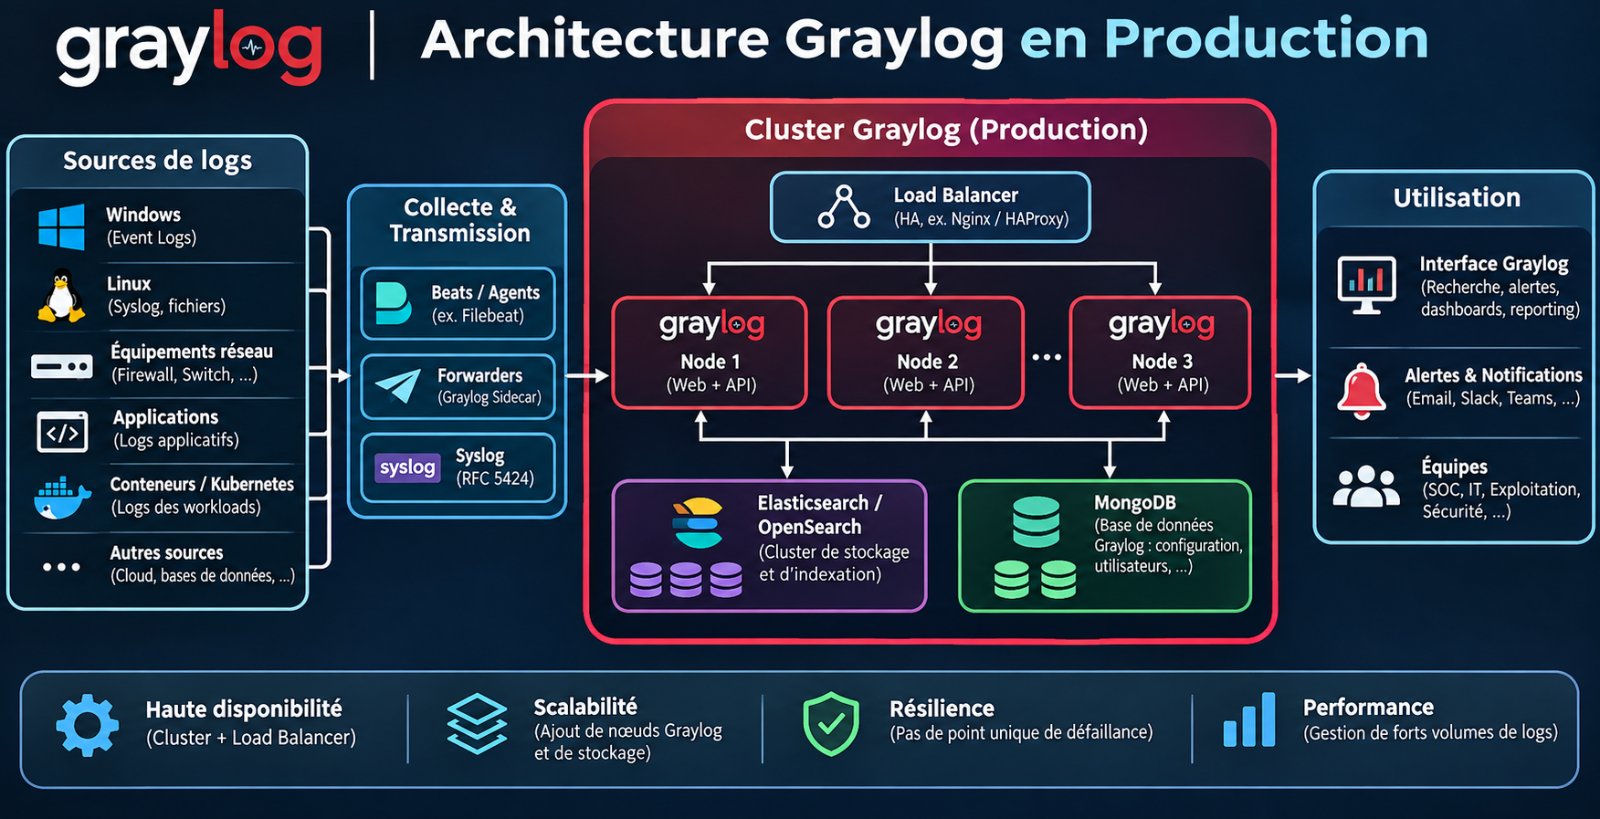
Centraliser les journaux est devenu incontournable : détection des incidents de sécurité, exigences d'audit, diagnostic des pannes. Mais une plateforme de logs mal conçue devient vite elle-même un point de fragilité : perte de messages pendant une maintenance, disques saturés, recherches qui s'effondrent au pire moment.
Cet article décrit une architecture Graylog de production éprouvée : 3 nœuds Graylog, 3 nœuds OpenSearch, un input par périmètre technologique, un stream par input et des index répliqués (replica 1). Nous y ajoutons tout ce qui fait la différence en exploitation : répartition de charge, sécurité, sauvegarde, supervision et dimensionnement.
Les objectifs de l'architecture
- Aucun point de défaillance unique : la perte d'un nœud, quel qu'il soit, ne doit ni interrompre la collecte ni rendre les données inaccessibles.
- Une organisation lisible : chaque famille de sources (Linux, Windows, réseau, applications…) est isolée, avec ses règles de traitement, ses droits et sa durée de conservation.
- Des performances prévisibles : la charge est répartie et les index sont dimensionnés pour rester rapides.
- Une plateforme exploitable : supervision, sauvegarde et procédures de mise à jour sont prévues dès le départ.
Vue d'ensemble
  Sources (serveurs, postes, équipements réseau, applications)
        |  Syslog TLS / Beats / GELF
        v
  +--------------------------------------------+
  |  Répartiteur de charge (HAProxy + VIP)     |
  +--------------------------------------------+
        |                 |                 |
  +-----------+     +-----------+     +-----------+
  | Graylog 1 |     | Graylog 2 |     | Graylog 3 |
  | MongoDB   |     | MongoDB   |     | MongoDB   |
  +-----------+     +-----------+     +-----------+
        \                 |                 /
         \________________|________________/
                          |  HTTPS
  +-------------+   +-------------+   +-------------+
  | OpenSearch 1|   | OpenSearch 2|   | OpenSearch 3|
  | master+data |   | master+data |   | master+data |
  +-------------+   +-------------+   +-------------+
                          |
               Snapshots (NFS / S3)
Les sources envoient leurs journaux vers une adresse virtuelle unique portée par le répartiteur. Celui-ci distribue les flux entre les trois nœuds Graylog, qui traitent les messages et les indexent dans le cluster OpenSearch. MongoDB, qui stocke la configuration de Graylog (inputs, streams, utilisateurs, tableaux de bord), tourne en replica set sur les trois nœuds Graylog.
Les composants et leur rôle
| Composant | Nombre | Rôle | Point d'attention |
|---|---|---|---|
| Répartiteur (HAProxy + keepalived) | 2 | Adresse virtuelle unique, répartition TCP/UDP, contrôle de santé | Contrôle de santé sur l'API /api/system/lbstatus |
| Graylog Server | 3 | Réception, traitement (pipelines), indexation, interface web | Journal disque local pour absorber les pics et les indisponibilités d'OpenSearch |
| MongoDB (replica set) | 3 | Configuration et métadonnées de Graylog | Majorité requise : 2 membres sur 3 doivent rester disponibles |
| OpenSearch | 3 | Stockage et recherche des messages | Nœuds à la fois éligibles maître et data ; disques rapides |
Côté versions, la branche Graylog 7 requiert Java 21 (fourni avec les paquets) et MongoDB 7.0 ou plus. Elle prend en charge OpenSearch jusqu'à la branche 3.x ; Elasticsearch et OpenSearch 1.x y sont dépréciés. Graylog propose aussi son Data Node, un OpenSearch géré par Graylog (certificats, mises à jour) : une alternative intéressante si vous ne souhaitez pas administrer OpenSearch vous-même. Vérifiez toujours la matrice de compatibilité de la version que vous déployez.
Le cluster OpenSearch : 3 nœuds et replica 1
Pourquoi trois nœuds
Trois nœuds éligibles maître permettent d'obtenir un quorum : si un nœud tombe, les deux autres élisent un maître et le cluster continue de fonctionner, sans risque de « split-brain ». Avec deux nœuds, la perte de l'un bloquerait le cluster ; avec trois, on tolère une panne.
Ce que signifie replica 1
Chaque index est découpé en shards. Avec replicas = 1, chaque shard primaire possède une copie placée sur un autre nœud. Conséquences :
- la perte d'un nœud ne fait perdre aucune donnée : les copies prennent le relais et le cluster passe en état yellow le temps de reconstruire les répliques ;
- les recherches sont réparties sur davantage de copies, donc plus rapides ;
- le stockage est doublé : c'est le prix de la résilience.
Une réplique n'est pas une sauvegarde : une suppression d'index ou une erreur de manipulation est répliquée instantanément. Les snapshots restent indispensables (voir plus bas).
Shards et rotation
- 3 shards par index : un primaire par nœud, la charge d'écriture est équilibrée.
- Taille cible d'un shard : 10 à 50 Go. Trop de petits shards surcharge le cluster ; des shards trop gros ralentissent la récupération après panne.
- Rotation par taille ou par durée, au choix selon le volume du périmètre (par exemple quotidienne pour un gros flux, ou tous les 20 Go).
- Heap JVM : 50 % de la RAM du nœud, sans dépasser 31 Go ; le reste sert au cache du système de fichiers, essentiel pour les recherches.
Le cluster Graylog : 3 nœuds actifs
Les trois nœuds Graylog sont actifs simultanément : ils reçoivent, traitent et indexent tous des messages. L'un d'eux joue le rôle de leader pour les tâches de maintenance (rotation des index, rétention), mais la perte de ce nœud n'interrompt pas la collecte.
- Journal disque (
message_journal_max_size) : chaque nœud écrit les messages reçus dans un journal local avant de les traiter. Si OpenSearch ralentit ou devient indisponible, les messages s'accumulent dans le journal au lieu d'être perdus. Prévoyez un disque dédié et rapide, dimensionné pour plusieurs heures de flux. - Inputs globaux : chaque input est démarré sur les trois nœuds, ce qui permet au répartiteur d'envoyer les flux à n'importe lequel d'entre eux.
- Contrôle de santé : le répartiteur interroge
/api/system/lbstatus; un nœud en maintenance peut être retiré proprement de la répartition avant son arrêt. - URL publique :
http_external_uridoit pointer vers l'adresse du répartiteur pour que l'interface web fonctionne derrière celui-ci.
Un input par périmètre technologique
Plutôt qu'un unique input Syslog qui reçoit tout, on crée un input par famille de sources, chacun sur son propre port. Exemple :
| Périmètre | Type d'input | Port (exemple) | Agent côté source |
|---|---|---|---|
| Systèmes Linux | Syslog TCP (TLS) | 6514 | rsyslog / syslog-ng |
| Systèmes Windows | Beats (TLS) | 5044 | Winlogbeat ou Graylog Sidecar |
| Réseau et sécurité | Syslog TCP/UDP | 1514 | Pare-feu, commutateurs, proxys |
| Virtualisation | Syslog TCP | 1515 | Hyperviseurs, vCenter |
| Applications | GELF TCP (TLS) | 12201 | Bibliothèques GELF, conteneurs |
| Bases de données | Beats ou Syslog | 5045 | Filebeat, agents natifs |
Les avantages sont nombreux :
- Traitement adapté : chaque format (Windows Event Log, syslog réseau, JSON applicatif) a ses propres règles d'analyse.
- Isolation : un équipement qui inonde la plateforme n'impacte que son input, que l'on peut limiter ou suspendre sans couper le reste.
- Visibilité : le débit de chaque périmètre se lit directement dans les métriques de l'input.
- Filtrage réseau simple : un port par périmètre facilite l'écriture des règles de pare-feu.
Bonne pratique : ajoutez à chaque input un champ statique (par exemple perimetre = linux). Ce champ sert ensuite aux streams, aux tableaux de bord et aux alertes, et reste lisible même si l'identifiant de l'input change.
Un stream et un index set par input
Chaque input alimente son propre stream :
- Règle du stream :
gl2_source_inputégal à l'identifiant de l'input (ouperimetreégal à la valeur du champ statique). - Option « Retirer du stream par défaut » activée : chaque message n'est stocké qu'une fois, dans l'index de son périmètre.
- Un index set dédié par stream, avec sa propre rotation et sa propre durée de conservation.
| Index set | Shards / replicas | Rotation | Conservation (exemple) |
|---|---|---|---|
| linux_* | 3 / 1 | Quotidienne | 90 jours |
| windows_* | 3 / 1 | 20 Go | 180 jours |
| reseau_* | 3 / 1 | 20 Go | 365 jours |
| virtualisation_* | 3 / 1 | Quotidienne | 90 jours |
| applications_* | 3 / 1 | Quotidienne | 30 jours |
Cette séparation permet d'appliquer à chaque périmètre la durée imposée par la politique de sécurité ou la réglementation, sans conserver inutilement des téraoctets de journaux applicatifs. Elle rend aussi les recherches plus rapides : interroger le stream « réseau » ne parcourt que les index réseau.
Les pipelines de traitement
Les règles de pipeline sont rattachées à chaque stream et organisées en étapes :
- Analyse : extraction des champs (grok, clé=valeur, JSON).
- Normalisation : noms de champs communs à tous les périmètres (
source_ip,user_name,event_action…), indispensables pour corréler. - Enrichissement : géolocalisation des adresses IP, tables de correspondance (inventaire des actifs, comptes à privilèges).
- Réduction du bruit : suppression des messages sans valeur (débogage, contrôles de santé répétitifs), pour économiser stockage et performances.
Sécurité de la plateforme
Une plateforme de logs contient des informations sensibles et constitue une cible de choix. À prévoir :
- Chiffrement partout : inputs en TLS, communications Graylog ↔ OpenSearch en HTTPS avec authentification, MongoDB avec authentification et TLS.
- Contrôle d'accès par périmètre : grâce aux streams, l'équipe réseau ne voit que les journaux réseau, l'équipe système que les siens. Authentification centralisée via LDAP/Active Directory ou SSO, avec MFA.
- Segmentation réseau : OpenSearch et MongoDB ne sont joignables que depuis les nœuds Graylog ; seuls les ports des inputs et l'interface web sont exposés, derrière le répartiteur.
- Traçabilité : journalisez les accès et actions des administrateurs de la plateforme elle-même.
Matrice des flux (exemple)
| Origine | Destination | Port | Usage |
|---|---|---|---|
| Sources | VIP répartiteur | Ports des inputs | Envoi des journaux |
| Administrateurs | VIP répartiteur | 443 | Interface web Graylog |
| Répartiteur | Nœuds Graylog | Inputs + 9000 | Répartition et contrôle de santé |
| Nœuds Graylog | Nœuds OpenSearch | 9200 | Indexation et recherche |
| Nœuds Graylog | Nœuds Graylog | 27017 | Replica set MongoDB |
| Nœuds OpenSearch | Nœuds OpenSearch | 9300 | Communication interne du cluster |
Haute disponibilité : que se passe-t-il en cas de panne ?
| Incident | Effet | Impact utilisateur |
|---|---|---|
| Perte d'un nœud Graylog | Le répartiteur le retire ; les deux autres absorbent le flux | Aucun (hors connexions UDP en cours) |
| Perte d'un nœud OpenSearch | Les répliques deviennent primaires, cluster en yellow | Aucun ; performances réduites pendant la reconstruction |
| Perte d'un membre MongoDB | Les deux membres restants conservent la majorité | Aucun |
| OpenSearch indisponible | Les messages s'accumulent dans les journaux disque de Graylog | Recherches impossibles, aucune perte tant que le journal n'est pas plein |
Point de vigilance : le syslog UDP n'offre aucune garantie de livraison. Privilégiez TCP avec TLS dès que les équipements le permettent. Pour les sites distants, un relais local (Graylog Forwarder, syslog-ng ou rsyslog avec file d'attente disque) met les messages en mémoire tampon en cas de coupure réseau et limite le nombre de flux à ouvrir vers le centre.
Sauvegarde et restauration
- Snapshots OpenSearch vers un dépôt partagé (NFS ou stockage objet compatible S3), planifiés quotidiennement et conservés selon votre politique. Ils sont incrémentaux : seuls les nouveaux segments sont copiés.
- Sauvegarde de MongoDB (mongodump) : elle contient toute la configuration de Graylog.
- Fichiers de configuration (
server.conf, certificats) et content packs exportés, versionnés dans un dépôt Git. - Tests de restauration réguliers : une sauvegarde jamais restaurée n'est pas une sauvegarde.
Supervision de la plateforme
Surveillez au minimum :
- l'état du cluster OpenSearch (green, yellow, red) et le nombre de shards non alloués ;
- l'occupation des disques d'OpenSearch : au-delà des seuils (par défaut 85 %, 90 % puis 95 %), OpenSearch cesse d'allouer des shards puis bloque l'écriture ;
- l'utilisation du journal Graylog et des buffers de traitement : un journal qui grossit signale un goulot d'étranglement ;
- le débit par input : une chute brutale signale une source qui n'envoie plus rien, souvent plus inquiétante qu'un pic ;
- l'état du replica set MongoDB et des certificats (dates d'expiration).
Graylog peut exposer ses métriques au format Prometheus, ce qui facilite l'intégration à une supervision existante.
Dimensionner le stockage
La formule de base :
Stockage total = volume journalier × durée de conservation × (1 + replicas) × 1,1
Stockage par nœud = stockage total ÷ 3, plus 20 à 25 % de marge
Exemple : 50 Go de journaux par jour conservés 90 jours avec replica 1 donnent 50 × 90 × 2 × 1,1 ≈ 9,9 To, soit environ 3,3 To par nœud OpenSearch, à porter à 4 To avec la marge nécessaire pour rester sous les seuils d'alerte. Le facteur 1,1 couvre le surcoût d'indexation, qui varie selon la richesse des champs extraits.
| Rôle | vCPU | RAM | Disques |
|---|---|---|---|
| Graylog + MongoDB | 8 | 16 à 32 Go | Système + journal dédié (SSD, 100 à 200 Go) |
| OpenSearch | 8 à 16 | 32 à 64 Go | SSD, selon la formule ci-dessus |
Ces valeurs sont un point de départ pour quelques dizaines de gigaoctets par jour ; elles doivent être validées par un test de charge sur vos propres flux.
Checklist avant la mise en production
- Inputs en TLS, un par périmètre, avec champ statique
perimetre. - Un stream et un index set par input, retirés du stream par défaut.
- Rotation et conservation définies pour chaque index set, validées avec la sécurité et la conformité.
- Replica set MongoDB opérationnel et authentifié.
- Cluster OpenSearch en green, répliques allouées sur des nœuds différents.
- Répartiteur avec contrôle de santé et adresse virtuelle redondante.
- Snapshots planifiés et une restauration testée.
- Supervision et alertes en place (disques, journal, débit par input, certificats).
- Rôles et droits par périmètre, authentification centralisée avec MFA.
- Procédure de mise à jour nœud par nœud documentée.
En résumé
Trois nœuds Graylog, trois nœuds OpenSearch avec une réplique, un input et un stream par périmètre : cette architecture offre une plateforme sans point de défaillance unique, lisible pour les équipes et dont la conservation s'adapte à chaque type de journal. Elle ne devient vraiment robuste qu'avec ce qui l'entoure : chiffrement, sauvegardes testées, supervision et dimensionnement réaliste.
Vous préparez un déploiement Graylog ou souhaitez fiabiliser une plateforme existante ? BS Core IT Consulting vous accompagne de la conception à la mise en production, ainsi que pour la formation de vos équipes.